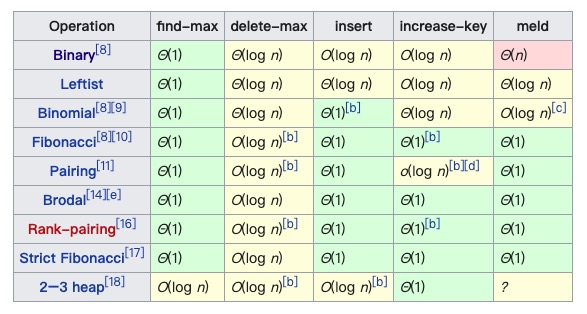
从表中可以看出,斐波那契堆、Brodal 队列和严格斐波那契堆达到了理论最优的复杂度(斐波那契堆是均摊意义上的,后两者是最坏情况意义上的)。不过理论最优不等于实践最快,实际工程中因为常数小、实现简单,用得最多的仍然是二叉堆。
# 二叉堆的定义和特性
二叉堆是计算机科学中一种非常著名的数据结构,由于它能高效、快速地找出最大值和最小值,常被应用于优先队列。它也被用于著名的堆排序算法中。
二叉堆是一种特殊的二叉树,有以下两个特性。
它是一棵完全二叉树,表示树的每一层都有左侧和右侧子节点(除了最后一层的叶节点), 并且最后一层的叶节点尽可能都是左侧子节点,这叫作结构特性。
二叉堆分为最小堆和最大堆。最小堆中任何一个节点的值,都小于或等于它左、右孩子节点的值。最大堆中任何一个节点的值,都大于或等于它左、右孩子节点的值。
二叉堆的根节点叫作堆顶。最大堆的堆顶是整个堆中的最大元素;最小堆的堆顶是整个堆中的最小元素。
尽管二叉堆是二叉树,但并不一定是二叉搜索树(BST)。在二叉堆中,每个子节点都要大于等于父节点(最小堆)或小于等于父节点(最大堆)。然而在二叉搜索树中,左侧子节点总是比父节点小,右侧子节点也总是更大。
对于堆中的第 n 个元素:
它的左子节点为 2 * n + 1;
它的右子节点为 2 * n + 2;
它的父节点为 (n - 1) / 2;
最后一个非叶子节点为 Math.floor(arr.length / 2) - 1。
- JS 中常用数组表示堆。
# 二叉堆的自我调整
所谓堆的自我调整,就是把一个不符合堆性质的完全二叉树,调整成一个堆。
对于二叉堆,有如下几种操作。
插入节点。
删除节点。
构建二叉堆。
这几种操作都基于堆的自我调整。下面以最小堆为例,看一看二叉堆是如何进行自我调整的。
# 插入节点
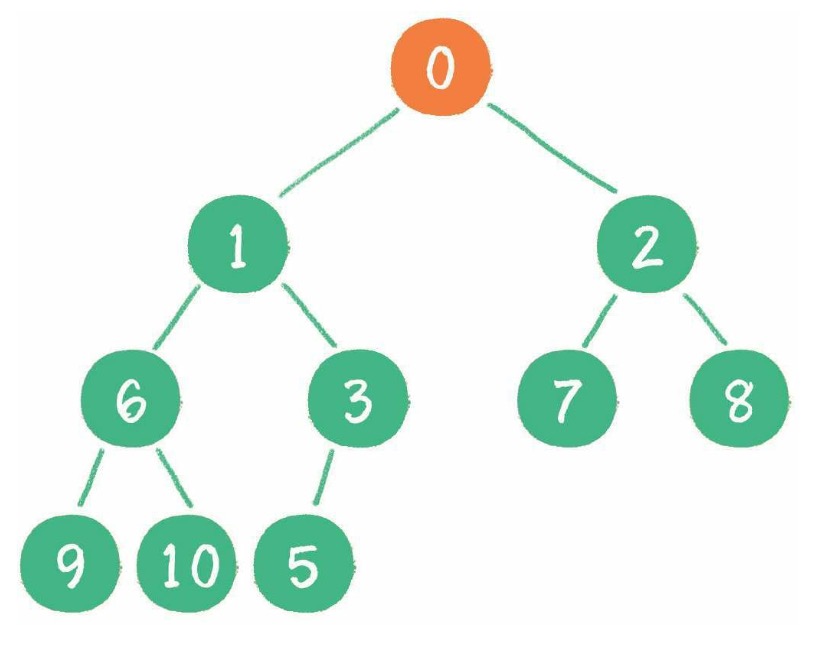
当二叉堆插入节点时,插入位置是完全二叉树的最后一个位置。例如插入一个新节点,值是 0。
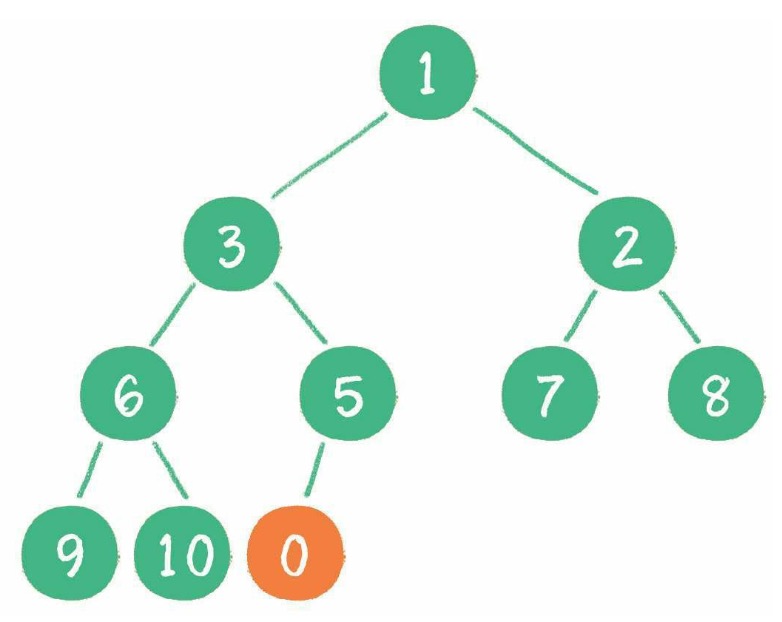
这时,新节点的父节点 5 比 0 大,显然不符合最小堆的性质。于是让新节点 “上浮”,和父节点交换位置。
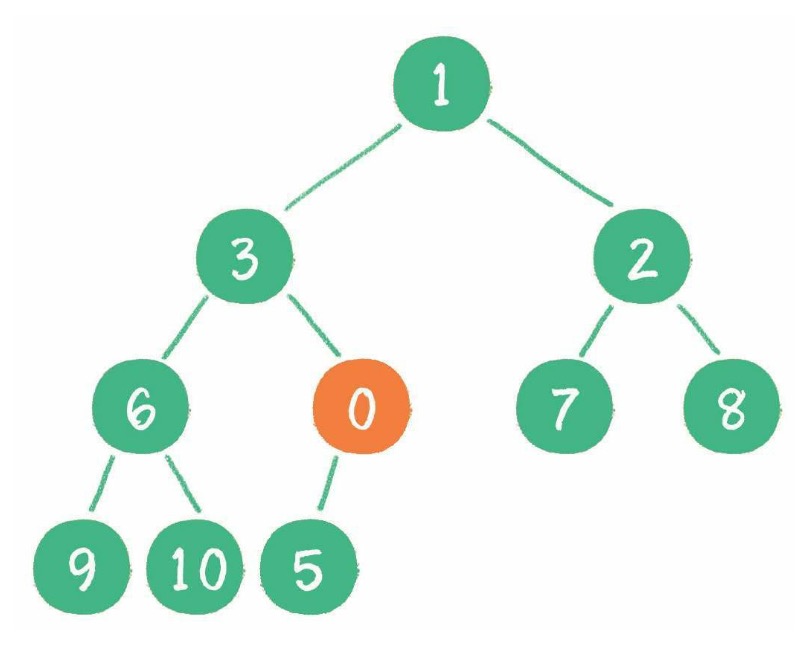
继续用节点 0 和父节点 3 做比较,因为 0 小于 3,则让新节点继续 “上浮”
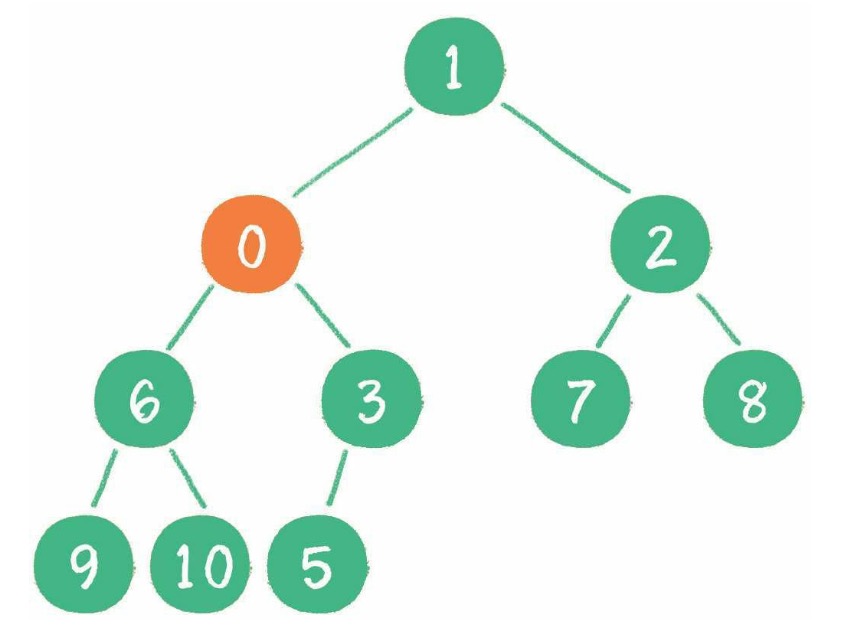
继续比较,最终新节点 0 “上浮” 到了堆顶位置。
# 删除节点
二叉堆删除节点的过程和插入节点的过程正好相反,所删除的是处于堆顶的节点。例如删除最小堆的堆顶节点 1。
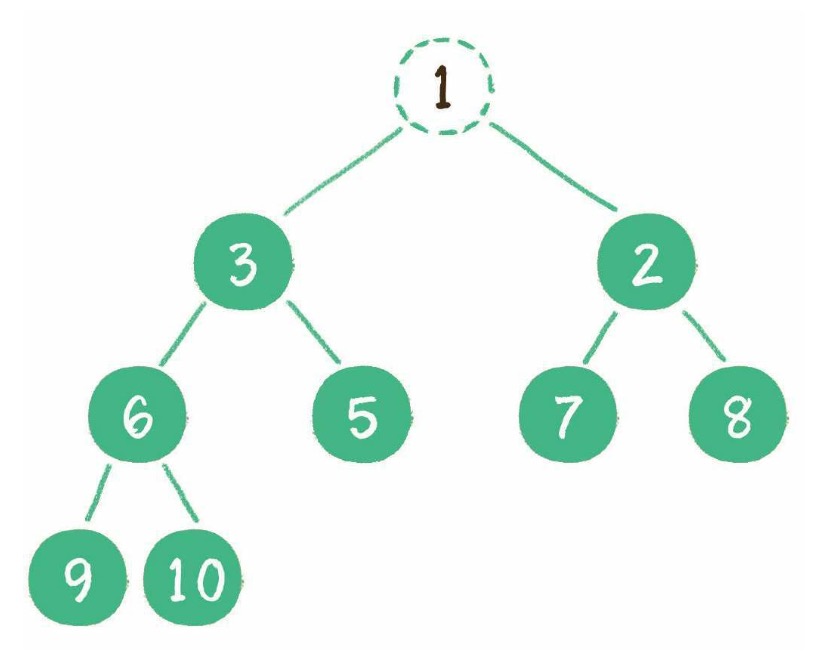
这时,为了继续维持完全二叉树的结构,我们把堆的最后一个节点 10 临时补到原本堆顶的位置。
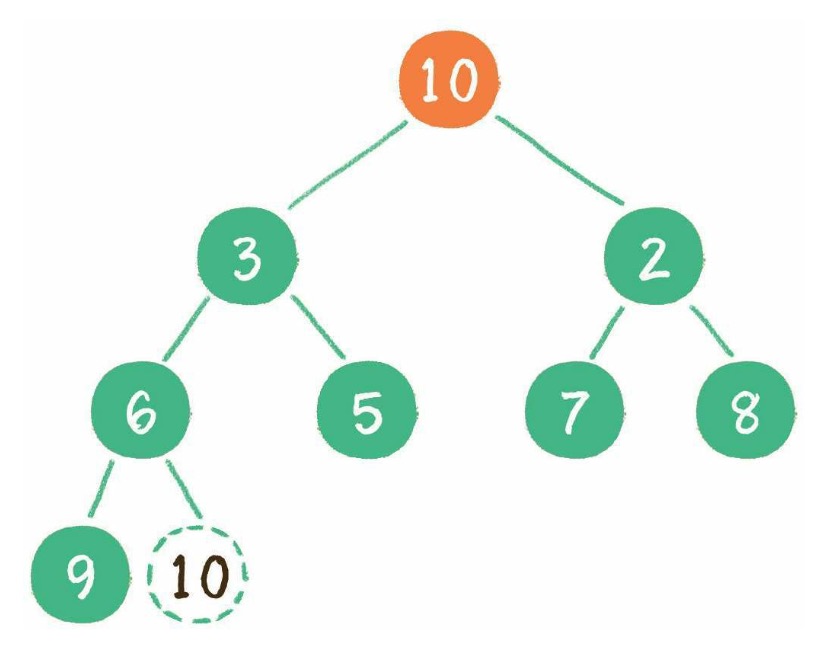
接下来,让暂处堆顶位置的节点 10 和它的左、右孩子进行比较,如果左、右孩子节点中最小的一个(显然是节点 2)比节点 10 小,那么让节点 10 “下沉”。
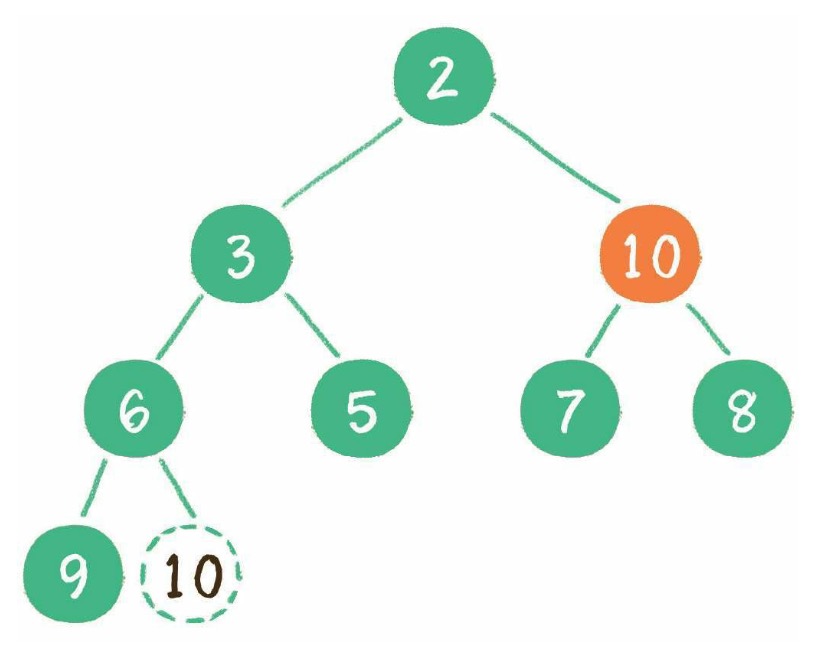
继续让节点 10 和它的左、右孩子做比较,左、右孩子中最小的是节点 7,由于 10 大于 7,让节点 10 继续 “下沉”。
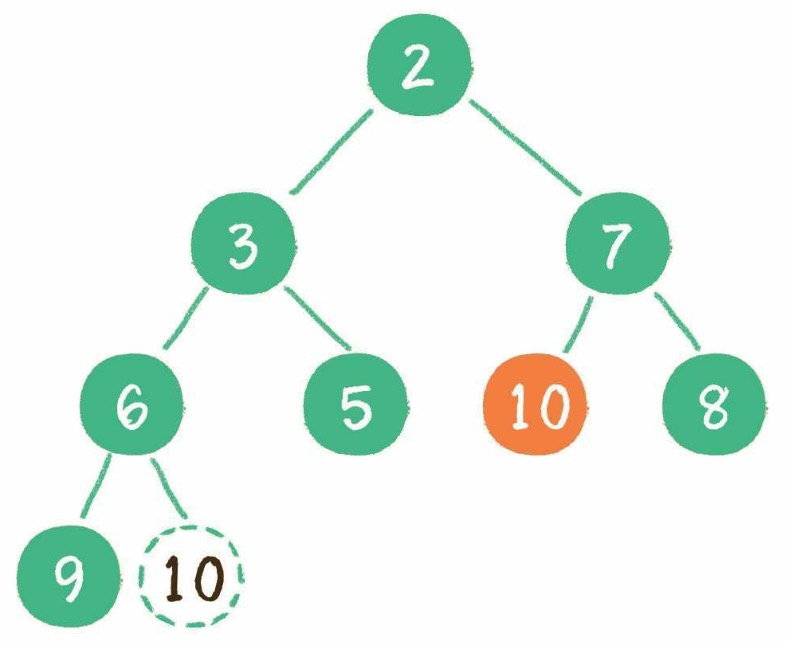
这样一来,二叉堆重新得到了调整。
# 构建二叉堆
构建二叉堆,也就是把一个无序的完全二叉树调整为二叉堆,本质就是让所有非叶子节点依次 “下沉”。
下面举一个无序完全二叉树的例子,如下图所示。
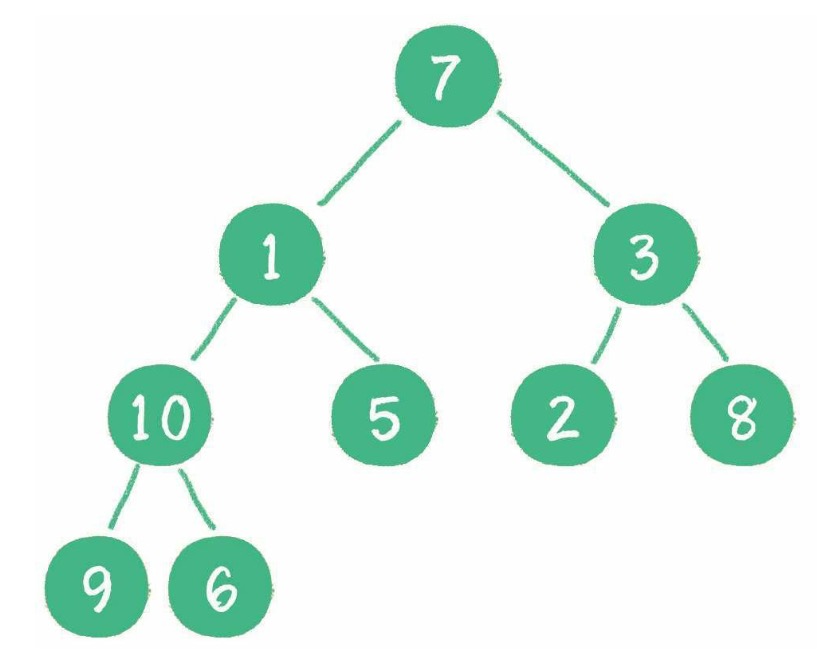
首先,从最后一个非叶子节点开始,也就是从节点 10 开始。如果节点 10 大于它左、右孩子节点中最小的一个,则节点 10 “下沉”。
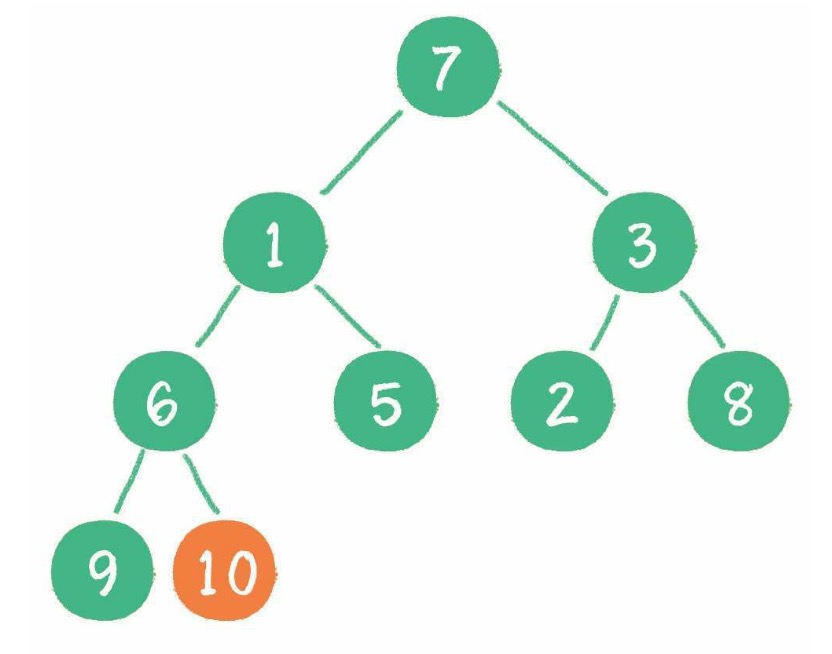
接下来轮到节点 3,如果节点 3 大于它左、右孩子节点中最小的一个,则节点 3 “下沉”。
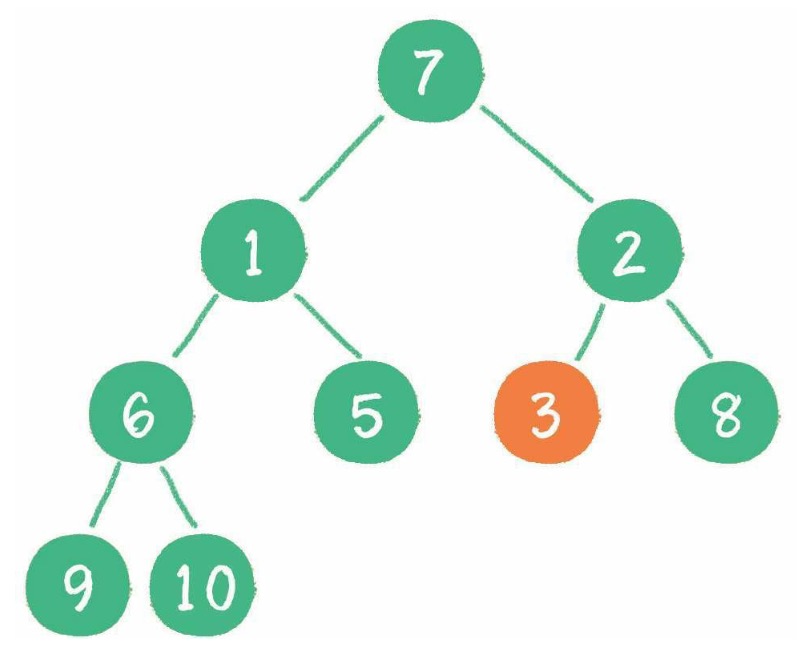
然后轮到节点 1,如果节点 1 大于它左、右孩子节点中最小的一个,则节点 1 “下沉”。事实上节点 1 小于它的左、右孩子,所以不用改变。
接下来轮到节点 7,如果节点 7 大于它左、右孩子节点中最小的一个,则节点 7 “下沉”。
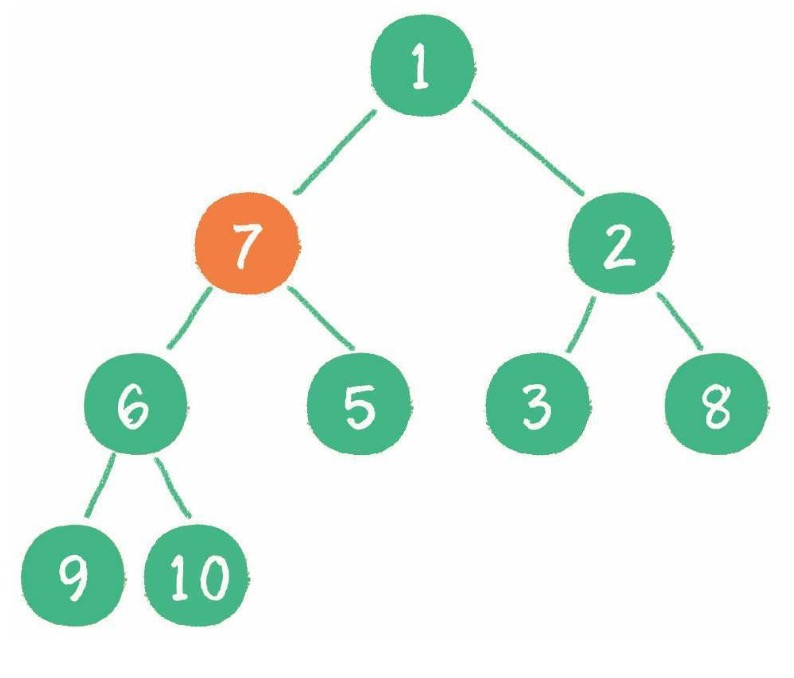
节点 7 继续比较,继续 “下沉”。
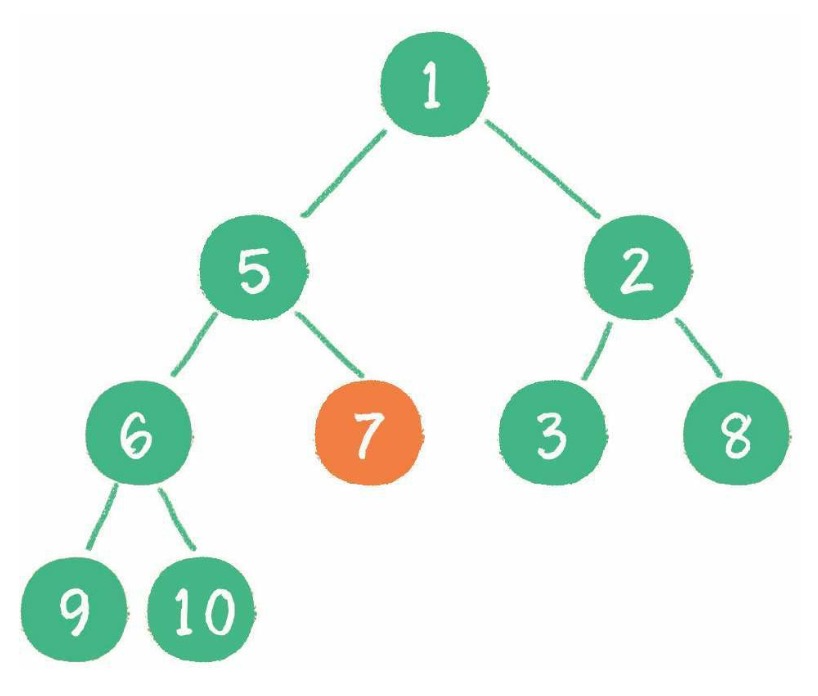
经过上述几轮比较和 “下沉” 操作,最终每一节点都小于它的左、右孩子节点,一个无序的完全二叉树就被构建成了一个最小堆。
# 二叉堆的时间复杂度
堆的插入操作是单一节点的 “上浮”,堆的删除操作是单一节点的 “下沉”,这两个操作的平均交换次数都是堆高度的一半,所以时间复杂度是 O(logn)。构建堆的时间复杂度是 O(n)。因此堆排序的时间复杂度是 O(nlogn)。
# 二叉堆的实现
二叉堆虽然是一个完全二叉树,但它的存储方式并不是链式存储,而是顺序存储。换句话说,二叉堆的所有节点都存储在数组中。
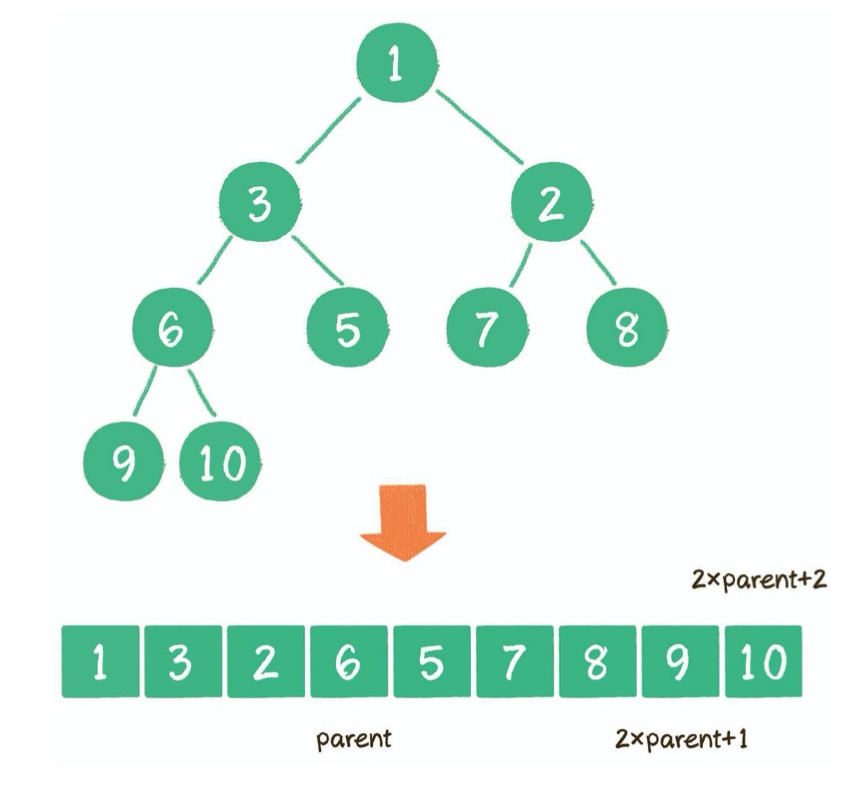
在数组中,在没有左、右指针的情况下,如何定位一个父节点的左孩子和右孩子呢?
像上图那样,可以依靠数组下标来计算。
假设父节点的下标是 parent,那么它的左孩子下标就是 2×parent+1;右孩子下标就是 2×parent+2。
下面实现的是最小堆。
/*
 * “上浮” 操作
 * @param array 待调整的堆
 */
function upAdjust(array) {
  let childIndex = array.length - 1;
  let parentIndex = Math.floor((childIndex - 1) / 2);
  // temp 保存插入的叶子节点值,用于最后赋值
  const temp = array[childIndex];
  while (childIndex > 0 && temp < array[parentIndex]) {
    // 无须真正交换,单向赋值即可
    array[childIndex] = array[parentIndex];
    childIndex = parentIndex;
    parentIndex = Math.floor((parentIndex - 1) / 2);
  }
  array[childIndex] = temp;
}

/*
 * “下沉” 操作
 * @param array 待调整的堆
 * @param parentIndex 要 “下沉” 的父节点
 * @param length 堆的有效大小
 */
function downAdjust(array, parentIndex, length) {
  // temp 保存父节点值,用于最后的赋值
  const temp = array[parentIndex];
  let childIndex = 2 * parentIndex + 1;
  while (childIndex < length) {
    // 如果有右孩子,且右孩子小于左孩子的值,则定位到右孩子
    if (childIndex + 1 < length && array[childIndex + 1] < array[childIndex]) {
      childIndex++;
    }
    // 如果父节点小于任何一个孩子的值,则直接跳出
    if (temp <= array[childIndex]) break;
    // 无须真正交换,单向赋值即可
    array[parentIndex] = array[childIndex];
    parentIndex = childIndex;
    childIndex = 2 * childIndex + 1;
  }
  array[parentIndex] = temp;
}

/*
 * 构建堆
 * @param array 待调整的堆
 */
function buildHeap(array) {
  // 从最后一个非叶子节点开始,依次做 “下沉” 调整
  for (let i = Math.floor((array.length - 2) / 2); i >= 0; i--) {
    downAdjust(array, i, array.length);
  }
}

const arr = [1, 3, 2, 6, 5, 7, 8, 9, 10, 0];
upAdjust(arr);
console.log(arr); // [0, 1, 2, 6, 3, 7, 8, 9, 10, 5]
const arr1 = [7, 1, 3, 10, 5, 2, 8, 9, 6];
buildHeap(arr1);
console.log(arr1); // [1, 5, 2, 6, 7, 3, 8, 9, 10]
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
上述代码中有一个优化的点,就是在父节点和孩子节点做连续交换时,并不一定要真的交换,只需要先把交换一方的值存入 temp 变量,做单向覆盖,循环结束后,再把 temp 的值存入交换后的最终位置即可。
# 使用最大堆实现从小到大排序
- 把无序数组构建成二叉堆。
升序:一般采用最大堆;
降序:一般采用最小堆。
- 循环删除堆顶元素,替换到二叉堆的末尾,调整堆产生新的堆顶。
/*
 * “下沉” 操作
 * @param array 待调整的堆
 * @param parentIndex 要 “下沉” 的父节点
 * @param length 堆的有效大小
 */
function downAdjust(array, parentIndex, length) {
  // temp 保存父节点值,用于最后的赋值
  const temp = array[parentIndex];
  let childIndex = 2 * parentIndex + 1;
  while (childIndex < length) {
    // 如果有右孩子,且右孩子大于左孩子的值,则定位到右孩子
    if (childIndex + 1 < length && array[childIndex + 1] > array[childIndex]) {
      childIndex++;
    }
    // 如果父节点大于任何一个孩子的值,则直接跳出
    if (temp >= array[childIndex]) break;
    // 无须真正交换,单向赋值即可
    array[parentIndex] = array[childIndex];
    parentIndex = childIndex;
    childIndex = 2 * childIndex + 1;
  }
  array[parentIndex] = temp;
}

/*
 * 堆排序(升序)
 * @param array 待调整的堆
 */
function heapSort(array) {
  // 1. 把无序数组构建成最大堆
  for (let i = Math.floor((array.length - 2) / 2); i >= 0; i--) {
    downAdjust(array, i, array.length);
  }
  // 2. 循环删除堆顶元素,移到集合尾部,调整堆产生新的堆顶
  for (let i = array.length - 1; i > 0; i--) {
    // 最后 1 个元素和第 1 个元素进行交换
    const temp = array[i];
    array[i] = array[0];
    array[0] = temp;
    // “下沉” 调整最大堆
    downAdjust(array, 0, i);
  }
}

const arr = [3, 2, 3, 1, 2, 4, 5, 5, 6];
heapSort(arr);
console.log(arr); // [1, 2, 2, 3, 3, 4, 5, 5, 6]
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
# 数组中的第 K 个最大元素 ✅
// 时间复杂度是 O(nlogn),排序的代价
// 空间复杂度是 O(logn),JS 引擎内置排序(快排/Timsort)的递归栈空间
// 降序排序,直接取第 k 个
var findKthLargest = function(nums, k) {
  nums.sort((a, b) => b - a);
  return nums[k - 1];
};

// 升序排序,从末尾数第 k 个
var findKthLargest = function(nums, k) {
  nums.sort((a, b) => a - b);
  return nums[nums.length - k];
};
2
3
4
5
6
7
8
9
10
11
12
13
// 最大堆 + 递归下沉
// 1. 把数组原地建成最大堆,堆顶是最大值
// 2. 循环 k-1 次:每次把堆顶(当前最大)换到数组末尾,堆大小减 1,再对堆顶做下沉恢复堆结构
// 3. 第 k 次时堆顶就是第 k 大的元素
// 时间复杂度是 O(nlogn),建堆 O(n),k 次下沉各 O(logn),总 O(n + klogn),最坏 k = n 时退化为 O(nlogn)
// 空间复杂度是 O(logn),maxHeapify 递归栈深度等于堆高度
var findKthLargest = function(nums, k) {
  let heapSize = nums.length; // 堆大小

  const swap = (a, i, j) => {
    let temp = a[i];
    a[i] = a[j];
    a[j] = temp;
  };

  // 下沉操作,对节点 i 进行下沉调整
  const maxHeapify = (nums, i, heapSize) => {
    const l = 2 * i + 1; // 左子节点
    const r = 2 * i + 2; // 右子节点
    let largest = i;
    if (l < heapSize && nums[l] > nums[largest]) {
      largest = l;
    }
    if (r < heapSize && nums[r] > nums[largest]) {
      largest = r;
    }
    if (largest !== i) {
      swap(nums, i, largest); // 找到左右子节点中较大的元素交换
      maxHeapify(nums, largest, heapSize); // 递归交换后面的节点
    }
  };

  const buildMaxHeap = (nums, heapSize) => {
    for (let i = Math.floor(nums.length / 2) - 1; i >= 0; i--) {
      // 从最后一个非叶子节点开始构建堆
      // 因为下沉操作(maxHeapify)的本质是:把一个节点和它的子节点比较,若比子节点小就交换
      // 叶子节点没有子节点,调用了也什么都不做,纯属浪费
      maxHeapify(nums, i, heapSize);
    }
  };

  buildMaxHeap(nums, heapSize); // 构建大顶堆
  // 前 k-1 次把最大值换到末尾,第 k 次时堆顶恰好是第 k 大,直接返回
  for (let i = nums.length - 1; i >= nums.length - k + 1; i--) {
    swap(nums, 0, i); // 交换堆顶和数组末尾元素
    heapSize--; // 堆大小减 1
    maxHeapify(nums, 0, heapSize); // 重新调整节点
  }
  return nums[0]; // 返回堆顶元素,就是第 k 大元素
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
// 最大堆 + 迭代下沉
// 和上一个方法的区别只有 downAdjust 的实现方式
// 时间复杂度是 O(nlogn),和方法二相同
// 空间复杂度是 O(1),迭代实现,无递归栈,只用了 temp 一个额外变量
var findKthLargest = function(nums, k) {
  let heapSize = nums.length;

  // 下沉操作
  const downAdjust = (array, parentIndex, length) => {
    // temp 保存父节点值,用于最后的赋值
    const temp = array[parentIndex];
    let childIndex = 2 * parentIndex + 1; // 左孩子
    while (childIndex < length) {
      // 如果有右孩子,且右孩子大于左孩子的值,则定位到右孩子
      if (
        childIndex + 1 < length &&
        array[childIndex + 1] > array[childIndex]
      ) {
        childIndex++;
      }
      // 如果父节点大于任何一个孩子的值,则直接跳出
      if (temp >= array[childIndex]) break;
      // 无须真正交换,单向赋值即可
      array[parentIndex] = array[childIndex];
      parentIndex = childIndex;
      childIndex = 2 * childIndex + 1;
    }
    array[parentIndex] = temp;
  };

  const buildMaxHeap = (nums, heapSize) => {
    for (let i = Math.floor(nums.length / 2) - 1; i >= 0; i--) {
      // 从最后一个非叶子节点开始构建堆
      downAdjust(nums, i, heapSize);
    }
  };

  buildMaxHeap(nums, heapSize); // 构建大顶堆

  // 前 k-1 个堆顶元素不断和数组的末尾元素交换,然后重新调整节点
  for (let i = nums.length - 1; i >= nums.length - k + 1; i--) {
    [nums[0], nums[i]] = [nums[i], nums[0]]; // 交换堆顶和数组末尾元素
    heapSize--; // 堆大小减 1
    downAdjust(nums, 0, heapSize); // 重新调整节点
  }

  return nums[0]; // 返回堆顶元素,就是第 k 大元素
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
# 前 K 个高频元素 ✅
// 时间复杂度是 O(nlogn),遍历统计 O(n),排序 O(nlogn),排序是瓶颈
// 空间复杂度是 O(n),Map 和转换后的数组最多存 n 个不同元素
var topKFrequent = function(nums, k) {
  const map = new Map();
  for (const n of nums) {
    // 遍历数组,用 Map 记录每个元素出现的次数
    map.set(n, map.has(n) ? map.get(n) + 1 : 1);
  }
  // 把 Map 转成 [元素, 频率] 的数组,按频率降序排序,取前 k 个元素
  return [...map.entries()]
    .sort((a, b) => b[1] - a[1])
    .map((item) => item[0])
    .slice(0, k);
};
2
3
4
5
6
7
8
9
10
11
12
13
14
// 桶排序:频率的最大值不会超过数组长度 n(一个元素最多出现 n 次),所以可以建 n + 1 个桶。
// 下标代表出现频率,把频率相同的元素放进同一个桶,最后从高频率的桶往低频率的桶收集元素,收够 k 个为止。
// 时间复杂度是 O(n),统计频率 O(n),放桶 O(n),收集 O(n),全程没有排序
// 空间复杂度是 O(n),Map 和桶数组都是 O(n)
var topKFrequent = function(nums, k) {
  // 第一步:统计每个元素的出现频率
  const map = new Map();
  for (const n of nums) {
    map.set(n, map.has(n) ? map.get(n) + 1 : 1);
  }

  // 第二步:把元素按频率放入对应的桶,桶下标 = 出现频率
  const buckets = new Array(nums.length + 1).fill(null).map(() => []);
  for (const [num, count] of map.entries()) {
    buckets[count].push(num);
  }

  // 第三步:桶下标即频率,从最高频率的桶开始往前收集,收够 k 个为止
  const res = [];
  for (let i = buckets.length - 1; i >= 0 && res.length < k; i--) {
    res.push(...buckets[i]);
  }

  // 最后一个桶可能有多个元素导致收集超过 k 个,slice 截断保证只返回 k 个
  return res.slice(0, k);
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
// 用大小为 k 的最小堆,堆里存 [元素, 频率],按频率比较。
// 堆顶始终是 "当前入选的 k 个元素中频率最低的",遍历所有元素后,堆里剩下的就是前 k 高频。
// 时间复杂度是 O(nlogk)。具体分两部分:先遍历数组统计频率,O(n);然后把 m 个不同元素依次过一遍大小为 k 的最小堆,每次堆调整是 O(logk),这部分是 O(mlogk)。因为 m 最大是 n,所以整体是 O(nlogk)。
// 空间复杂度是 O(n)。频率表要存 m 个键值对,最坏 O(n);堆本身只占 O(k),瓶颈在频率表。
var topKFrequent = function(nums, k) {
  // 第一步:统计每个元素的出现频率
  const map = new Map();
  for (const n of nums) {
    map.set(n, map.has(n) ? map.get(n) + 1 : 1);
  }

  // 最小堆,存 [元素, 频率],按频率比较,堆顶是已入选元素中频率最低的
  const heap = [];

  // 上浮:新元素放在堆末尾后往上调整,用于入堆
  const upAdjust = () => {
    let childIndex = heap.length - 1; // 新元素所在位置(堆末尾)
    let parentIndex = Math.floor((childIndex - 1) / 2); // 它的父节点位置
    const temp = heap[childIndex]; // 暂存新元素,用于最后赋值
    // 只要还没到堆顶,且新元素频率小于父节点频率,就继续上浮
    while (childIndex > 0 && temp[1] < heap[parentIndex][1]) {
      heap[childIndex] = heap[parentIndex]; // 父节点下移,无须真正交换,单向赋值即可
      childIndex = parentIndex; // 继续往上走
      parentIndex = Math.floor((parentIndex - 1) / 2);
    }
    heap[childIndex] = temp; // 把新元素放到最终位置
  };

  // 下沉:堆顶被替换后往下调整,用于恢复堆性质
  const downAdjust = () => {
    const temp = heap[0]; // 暂存堆顶元素,用于最后赋值
    let parentIndex = 0; // 从堆顶开始下沉
    let childIndex = 1; // 左孩子位置
    while (childIndex < heap.length) {
      // 如果有右孩子,且右孩子频率小于左孩子,则定位到右孩子(和更小的孩子比较)
      if (childIndex + 1 < heap.length && heap[childIndex + 1][1] < heap[childIndex][1]) {
        childIndex++;
      }
      // 如果父节点频率不大于孩子中较小的一个,堆性质已满足,直接跳出
      if (temp[1] <= heap[childIndex][1]) break;
      heap[parentIndex] = heap[childIndex]; // 孩子节点上移,无须真正交换,单向赋值即可
      parentIndex = childIndex; // 继续往下走
      childIndex = 2 * childIndex + 1;
    }
    heap[parentIndex] = temp; // 把原堆顶元素放到最终位置
  };

  // 第二步:遍历频率表,维护大小为 k 的最小堆
  for (const entry of map.entries()) {
    if (heap.length < k) {
      heap.push(entry); // 堆未满,直接入堆
      upAdjust();
    } else if (entry[1] > heap[0][1]) {
      heap[0] = entry; // 频率比堆顶高,堆顶出局,当前元素替换堆顶
      downAdjust();
    }
    // 频率不比堆顶高的直接跳过,连堆都不进
  }

  // 第三步:堆里剩下的就是前 k 高频元素
  return heap.map((entry) => entry[0]);
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62