并查集
# 并查集
并查集(Union-find Data Structure)是一种树型的数据结构。它的特点是由子结点找到父亲结点,用于处理一些不交集(Disjoint Sets)的合并及查询问题。
- Find:确定元素属于哪一个子集。它可以被用来确定两个元素是否属于同一子集。
- Union:将两个子集合并成同一个集合。
# 岛屿数量
class UnionFind {
  constructor(n) {
    this.count = n; // 集合的数量
    this.parent = new Array(n); // 节点的 parent
    this.rank = new Array(n); // 集合的深度,并查集中将深度称为 rank
    for (let i = 0; i < n; i++) {
      this.parent[i] = i; // 初始时节点的 parent 都指向自己
      this.rank[i] = 1;
    }
  }
  find(i) {
    while (this.parent[i] !== i) {
      // 并查集优化二,路经压缩
      this.parent[i] = this.find(this.parent[i]); // 也可以写成:this.parent[i] = this.parent[this.parent[i]];
      i = this.parent[i];
    }
    return i;
  }
  union(x, y) {
    let rootX = this.find(x);
    let rootY = this.find(y);
    if (rootX === rootY) return;
    // 并查集优化一,将深度较小的集合接在深度较大的集合下,这样整体的集合深度会较小
    if (this.rank[rootX] > this.rank[rootY]) {
      this.parent[rootY] = rootX;
    } else if (this.rank[rootX] < this.rank[rootY]) {
      this.parent[rootX] = rootY;
    } else {
      this.parent[rootY] = rootX;
      this.rank[rootX]++;
    }
    this.count--;
  }
  getCount() {
    return this.count;
  }
}

const numIslands = (grid) => {
  const m = grid.length;
  const n = grid[0].length;
  const dirs = [
    [-1, 0],
    [1, 0],
    [0, -1],
    [0, 1]
  ]; // 上下左右 4 个方向
  const uf = new UnionFind(m * n);
  const dummy = -1;
  for (let i = 0; i < m; i++) {
    for (let j = 0; j < n; j++) {
      if (grid[i][j] === "0") {
        uf.union(i * n + j, dummy);
      } else if (grid[i][j] === "1") {
        dirs.map((d) => {
          const r = i + d[0];
          const c = j + d[1];
          if (r >= 0 && r < m && c >= 0 && c < n && grid[r][c] === "1") {
            uf.union(i * n + j, r * n + c);
          }
        });
      }
    }
  }
  return uf.getCount();
};
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
# 单调栈
# 每日温度
// 维护一个存储下标的单调栈,从栈底到栈顶的下标对应的温度列表中的温度依次递减
// 如果一个下标在单调栈里,则表示尚未找到下一次温度更高的下标
// 由于单调栈满足从栈底到栈顶元素对应的温度递减,因此每次有元素进栈时,会将温度更低的元素全部移除,并更新出栈元素对应的等待天数,这样可以确保等待天数一定是最小的
var dailyTemperatures = function(temperatures) {
  const len = temperatures.length;
  const stack = [];
  const res = new Array(len).fill(0);
  for (let i = 0; i < len; i++) {
    while (
      stack.length !== 0 &&
      temperatures[i] > temperatures[stack[stack.length - 1]]
    ) {
      const stackTop = stack[stack.length - 1];
      stack.pop();
      res[stackTop] = i - stackTop;
    }
    stack.push(i);
  }
  return res;
};
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
# 排序
# 合并区间
var merge = function(intervals) {
  const res = [];
  intervals.sort((a, b) => a[0] - b[0]); // 先将所有区间按区间左端点进行升序排序
  res.push(intervals[0]);
  for (let i = 0; i < intervals.length; i++) {
    const len = res.length;
    if (intervals[i][0] > res[len - 1][1]) {
      // 如果当前区间的左端点大于结果数组中最后一个区间的右端点,则不需要合并
      res.push(intervals[i]);
    } else {
      if (intervals[i][1] > res[len - 1][1]) {
        // 如果当前区间的右端点大于结果数组中最后一个区间的右端点,则将后者置为前者
        res[len - 1][1] = intervals[i][1];
      }
    }
  }
  return res;
};
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 无重叠区间
var eraseOverlapIntervals = function(intervals) {
  intervals.sort((a, b) => a[1] - b[1]); // 先将所有区间按区间右端点进行升序排序
  const len = intervals.length;
  let count = 1;
  let right = intervals[0][1]; // 实时维护上一个选择区间的右端点
  for (let i = 0; i < len; i++) {
    if (intervals[i][0] >= right) {
      // 如果当前遍历到的区间与上一区间不重合,就可以贪心地选择这个区间,并更新 right
      count++;
      right = intervals[i][1];
    }
  }
  return len - count;
};
1
2
3
4
5
6
7
8
9
10
11
12
13
14
2
3
4
5
6
7
8
9
10
11
12
13
14
# 前缀和
# 除自身以外数组的乘积
var productExceptSelf = function(nums) {
  const len = nums.length;
  // l 和 r 分别表示左右两侧的乘积列表
  const l = new Array(len).fill(0);
  const r = new Array(len).fill(0);
  const res = new Array(len).fill(0);

  // l[i] 为索引 i 左侧所有元素的乘积
  // 对于索引为 0 的元素,因为左侧没有元素,所以 l[0] = 1
  l[0] = 1;
  for (let i = 1; i < len; i++) {
    l[i] = nums[i - 1] * l[i - 1];
  }

  // r[i] 为索引 i 右侧所有元素的乘积
  // 对于索引为 len - 1 的元素,因为右侧没有元素,所以 r[len - 1] = 1
  r[len - 1] = 1;
  for (let i = len - 2; i >= 0; i--) {
    r[i] = nums[i + 1] * r[i + 1];
  }

  // 对于索引 i,除 nums[i] 之外其余各元素的乘积就是左侧所有元素的乘积乘以右侧所有元素的乘积
  for (let i = 0; i < len; i++) {
    res[i] = l[i] * r[i];
  }

  return res;
};
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
// 空间复杂度为 O(1) 的方法
var productExceptSelf = function(nums) {
  const len = nums.length;
  const res = new Array(len).fill(0);

  // res[i] 表示索引 i 左侧所有元素的乘积
  res[0] = 1;
  for (let i = 1; i < len; i++) {
    res[i] = nums[i - 1] * res[i - 1];
  }

  // r 表示索引 i 右侧所有元素的乘积
  let r = 1;
  for (let i = len - 1; i >= 0; i--) {
    // 对于索引 i,左边的乘积为 res[i],右边的乘积为 r
    res[i] = res[i] * r;
    // r 需要包含右边所有的乘积,所以计算下一个结果时需要将当前值乘到 r 上
    r *= nums[i];
  }

  return res;
};
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
# 长度最小的子数组
// 前缀和 + 二分查找
var minSubArrayLen = function(target, nums) {
  const len = nums.length;
  let res = 0;
  let prefix = new Array(len).fill(0); // 前缀和
  prefix[0] = nums[0];
  for (let i = 1; i < len; i++) {
    prefix[i] = prefix[i - 1] + nums[i];
  }
  for (let i = 0; i < len; i++) {
    // 二分查找
    let left = i,
      right = len - 1;
    while (left <= right) {
      const mid = left + ((right - left) >> 1);
      const temp = i > 0 ? prefix[i - 1] : 0;
      const sum = prefix[mid] - temp;
      if (sum >= target) {
        res = res === 0 ? mid - i + 1 : Math.min(res, mid - i + 1);
        right = mid - 1;
      } else {
        left = mid + 1;
      }
    }
  }
  return res;
};
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
# LRU Cache
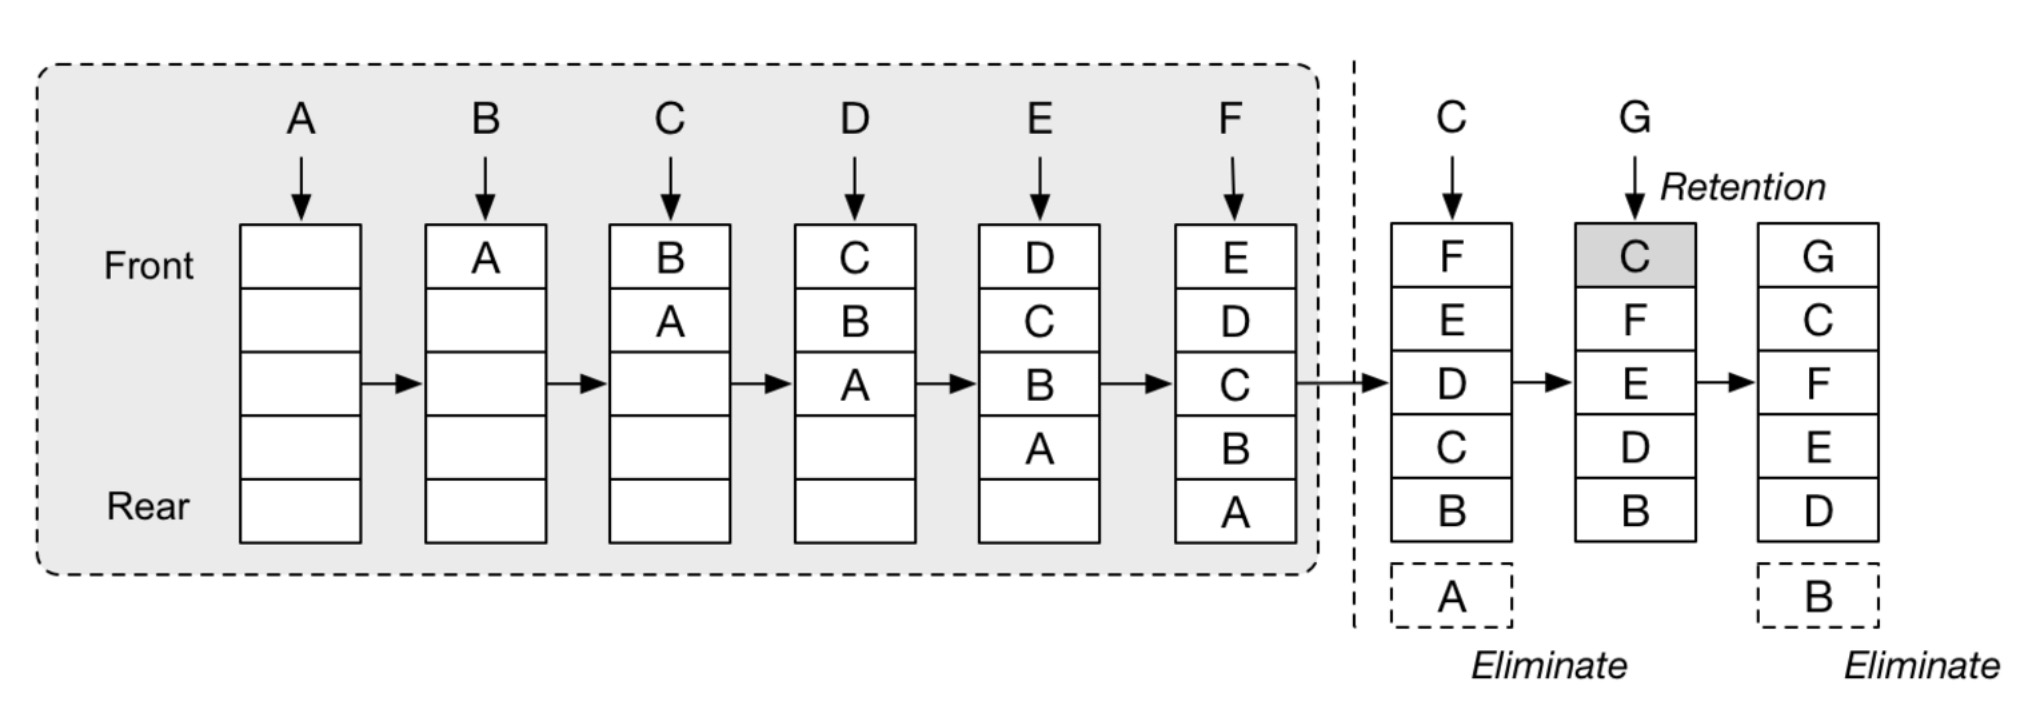
最近最少使用算法
根据最近使用时间来置换,一般使用双向链表来实现
查询:O(1),注意这里是查询最前和最后的节点时的时间复杂度,如果是中间节点就不是 O(1) 了
修改、更新:O(1)
# LRU 缓存
var LRUCache = function(capacity) {
  this.map = new Map();
  this.capacity = capacity;
};

LRUCache.prototype.get = function(key) {
  if (!this.map.has(key)) {
    return -1;
  }
  const value = this.map.get(key);
  this.map.delete(key);
  this.map.set(key, value);
  return value;
};

LRUCache.prototype.put = function(key, value) {
  if (this.map.has(key)) {
    this.map.delete(key);
  }
  this.map.set(key, value);
  if (this.map.size > this.capacity) {
    this.map.delete(this.map.keys().next().value);
  }
};
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
# LFU Cache
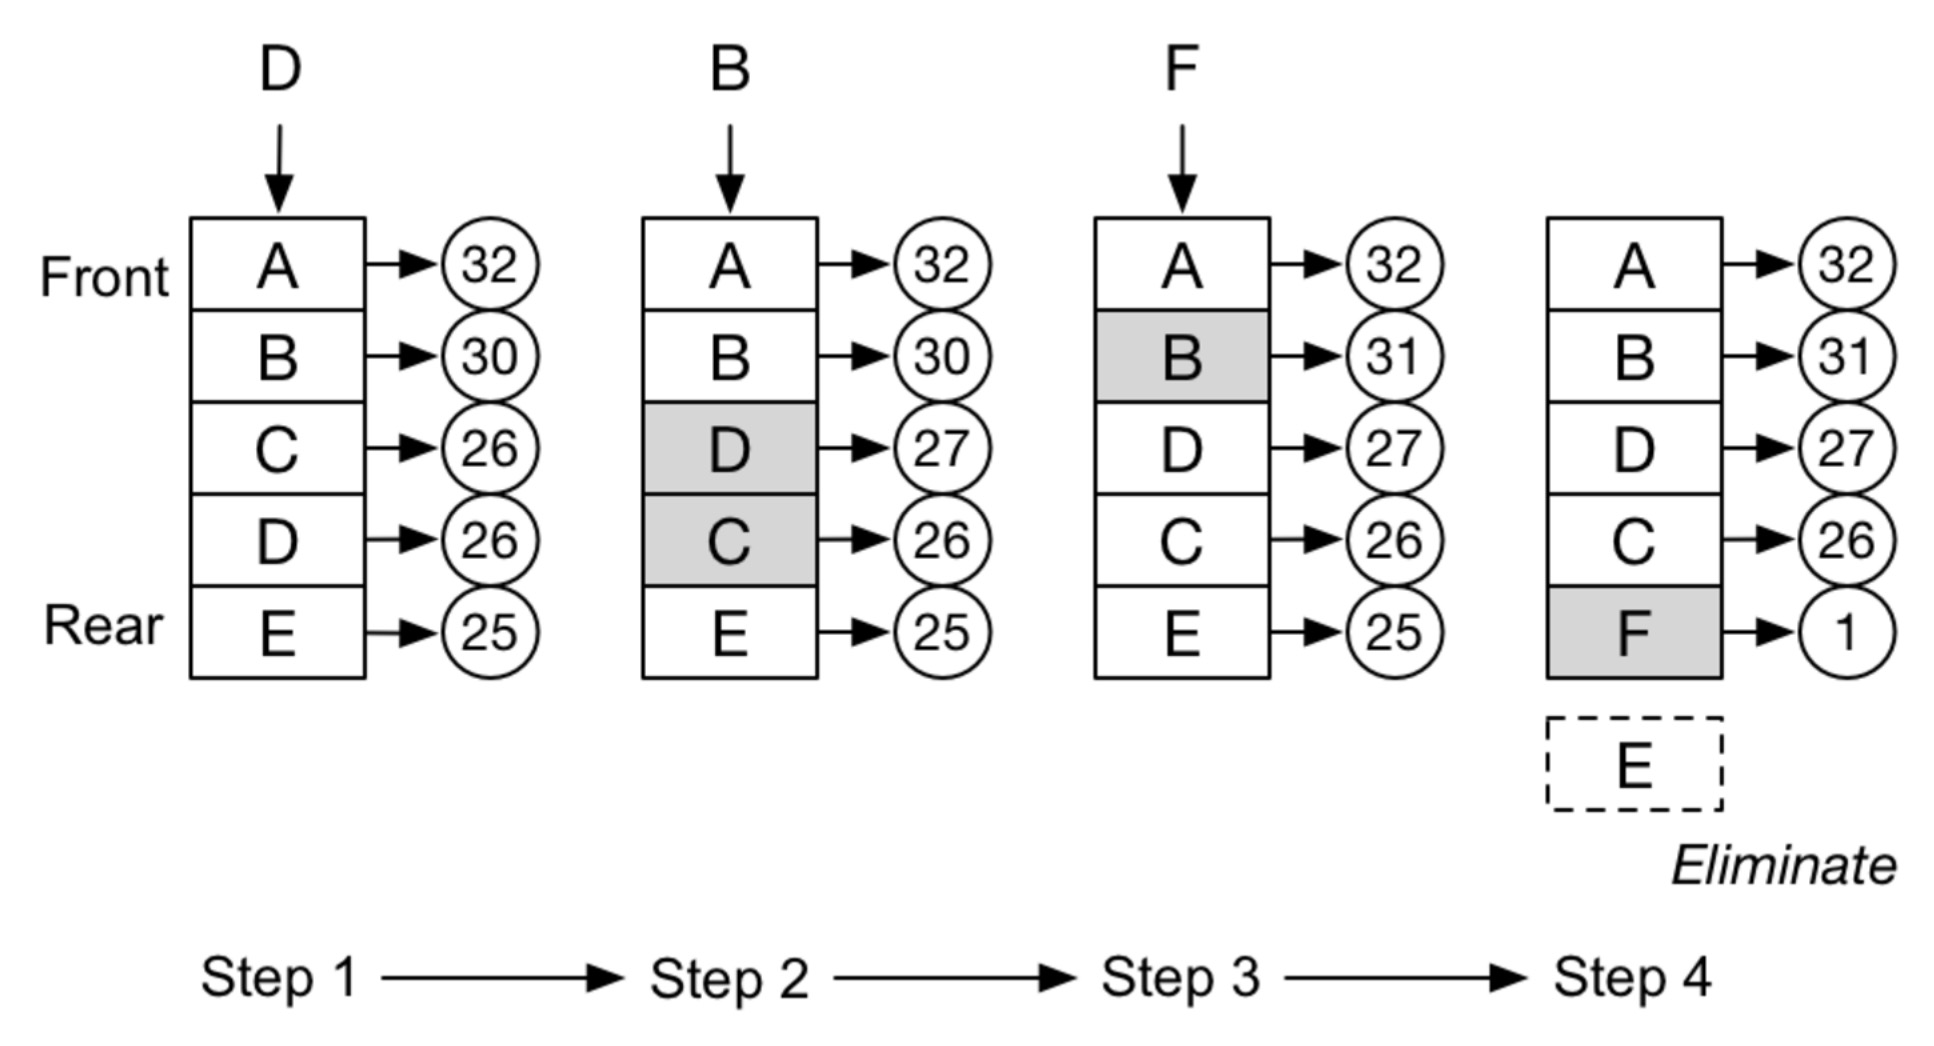
最近最不常使用算法
先考虑最近使用时间,再根据使用频次来置换
# 布隆过滤器
⼀个很⻓的⼆进制向量和⼀系列随机映射函数。
布隆过滤器(Bloom Filter)可以⽤于检索⼀个元素是否在⼀个集合中。如果检索到该元素不在集合中,那么是百分百正确的;如果检索到该元素在集合中,那么有一定的概率是误判。
它的优点是空间效率和查询时间都远远超过⼀般的算法,缺点是有⼀定的误识别率和删除困难。
应用:比特币、分布式系统。
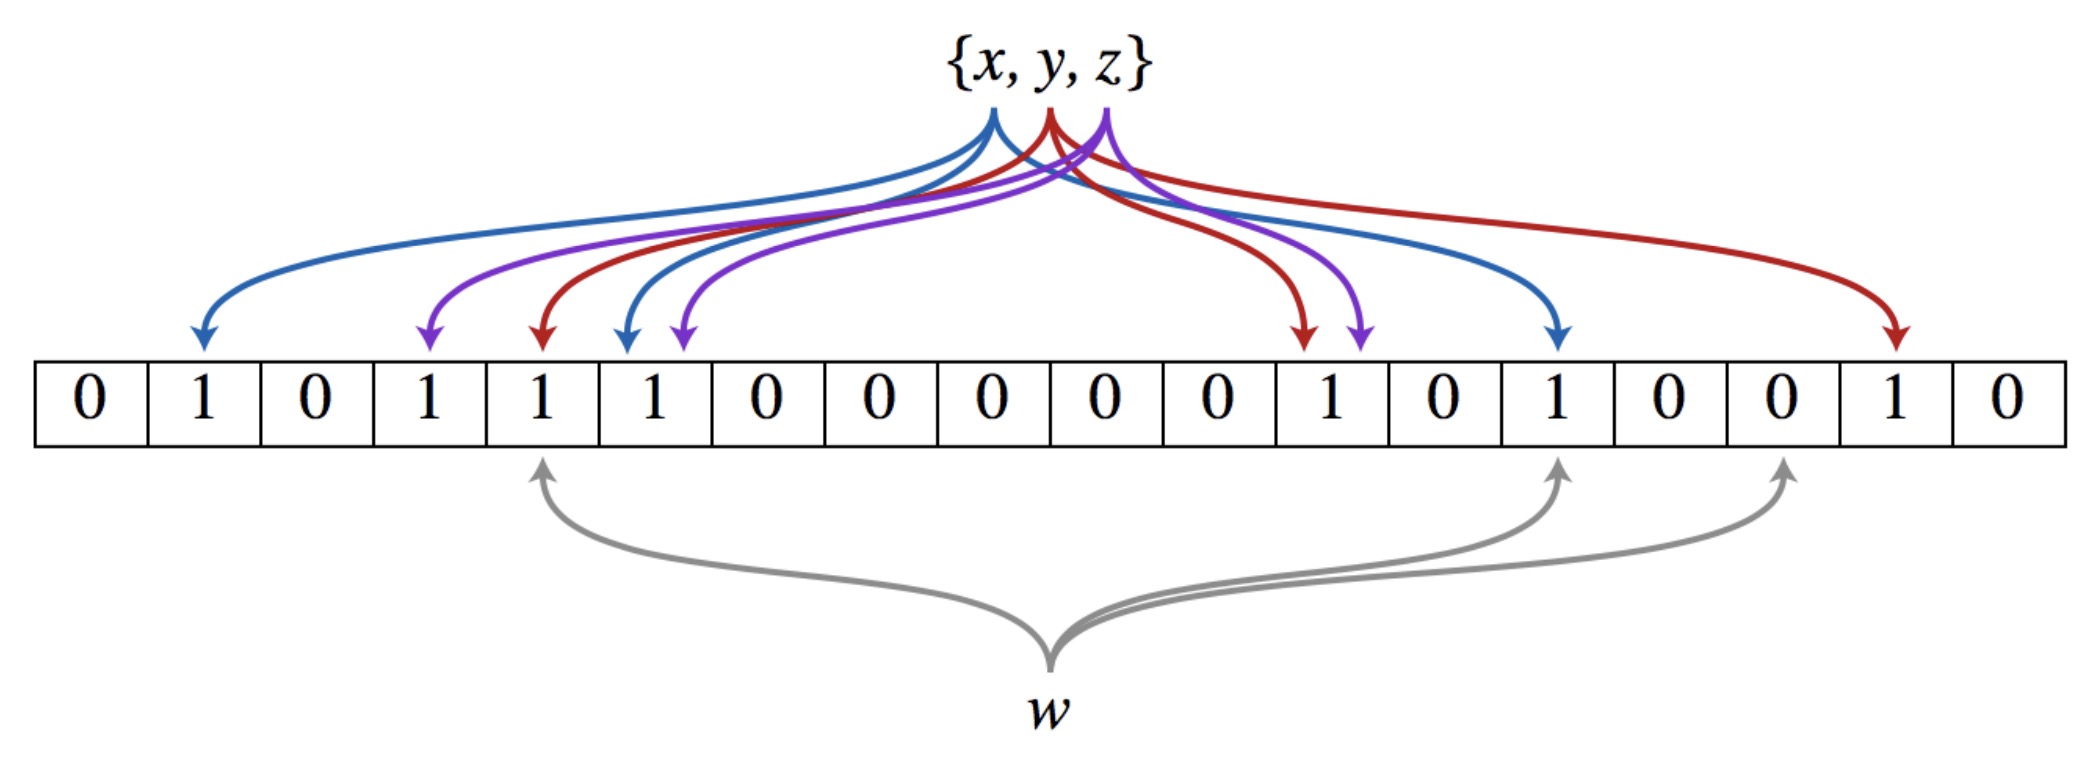
x、y、z 是事先插入到二进制向量中的,它们会把对应的位置置为 1,而 w 是来查询是否在这个集合中的,只要 w 对应的向量中的位有为 0 的,就说明它不在集合中。
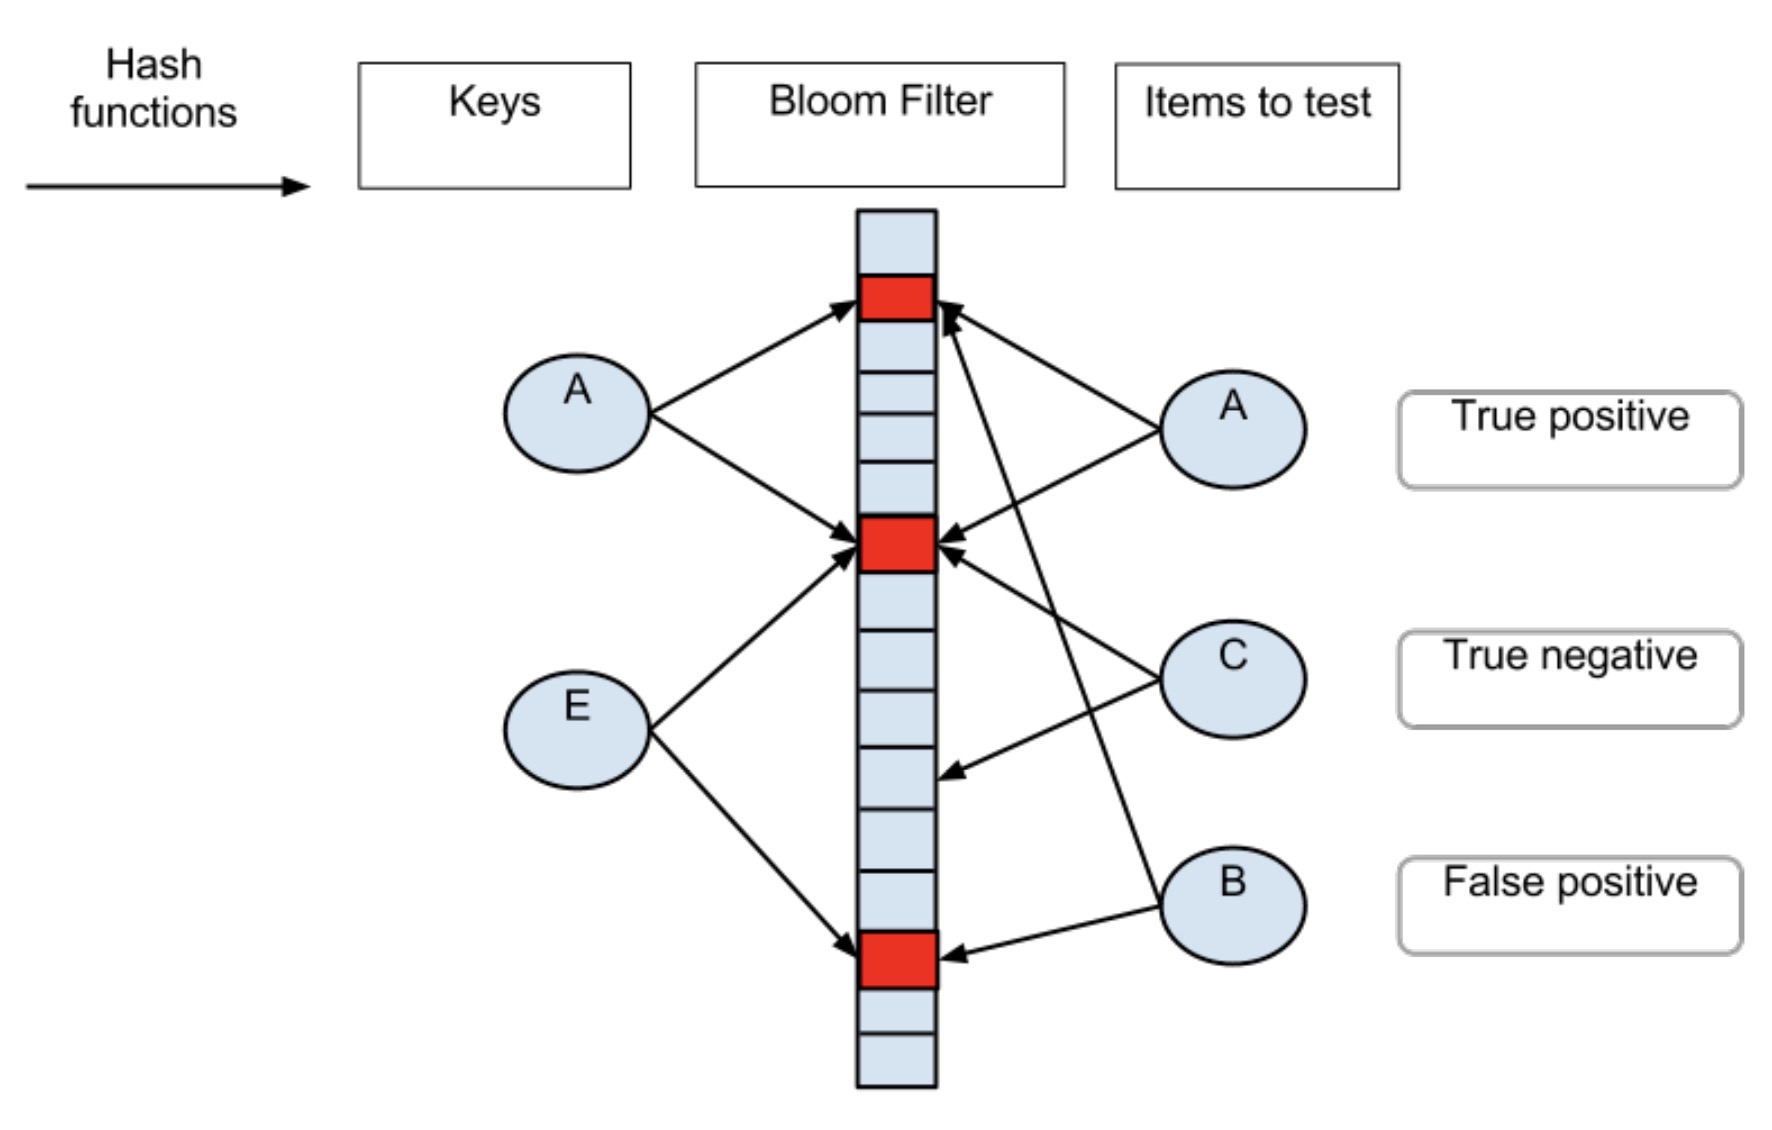
A、E 是事先插入到二进制向量中的,虽然 B 在二进制向量中对应的位都为 1,但实际上并没有这个值,所以此时判断 B 在集合中就属于误判。