排序算法的时间和空间复杂度
# 排序算法的时间和空间复杂度
# 排序算法的稳定性
假定在待排序的记录序列中,存在多个具有相同的关键字的记录,若经过排序,这些记录的相对次序保持不变,即在原序列中,r[i]=r[j],且 r[i]在 r[j]之前,而在排序后的序列中,r[i]仍在 r[j]之前,则称这种排序算法是稳定的;否则称为不稳定的。排序算法的稳定性 (opens new window)
稳定的排序算法有:冒泡排序、插入排序、归并排序、计数排序、桶排序和基数排序。
不稳定的排序算法有:选择排序、快速排序、希尔排序、堆排序。
# 冒泡排序 ✅
# 冒泡排序的思路
依次比较相邻的两个数,如果第一个比第二个小,不变。如果第一个比第二个大,调换顺序。一轮下来,最后一个是最大的数。
对除了最后一个之外的数重复第一步,直到只剩一个数。
# 冒泡排序的实现
// 交换数组中下标 i 和 j 的两个元素
function swap(arr, i, j) {
  const temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

// 从前往后冒泡
// 时间复杂度是 O(n²),总比较次数是 n(n-1)/2;空间复杂度是 O(1),原地交换
function bubbleSort(arr) {
  if (arr.length < 2) {
    return arr;
  }
  const len = arr.length;
  // 外层控制轮数,每一轮结束后,未排序部分的最大值 "冒" 到末尾
  for (let i = 0; i < len; i++) {
    // 末尾 i 个元素已就位,属于有序区,不用再比,所以边界是 len - 1 - i
    for (let j = 0; j < len - 1 - i; j++) {
      // 相邻两两比较,大的往后换;相等不交换,保证了排序的稳定性
      if (arr[j] > arr[j + 1]) {
        swap(arr, j, j + 1);
      }
    }
  }
  return arr;
}

// 从后往前冒泡:本质和上面相同,只是外层循环变量换成递减计数
// 时间复杂度是 O(n²);空间复杂度是 O(1)
function bubbleSort(arr) {
  if (arr.length < 2) {
    return arr;
  }
  const len = arr.length;
  // i 表示本轮参与比较的元素个数,每轮结束后减 1(最大值已就位)
  for (let i = len; i >= 2; i--) {
    // 只需比到 i - 1 为止,arr[i - 1] 之后是有序区
    for (let j = 0; j < i - 1; j++) {
      if (arr[j] > arr[j + 1]) {
        swap(arr, j, j + 1);
      }
    }
  }
  return arr;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
# 冒泡排序的优化
📌 优化点一
冒泡有一个最大的问题就是这种算法不管不管你有序还是没序,闭着眼睛把你循环比较了再说。
比如这个例子:[ 9,8,7,6,5 ],一个有序的数组,根本不需要排序,它仍然是双层循环一个不少的把数据遍历干净,这其实就是做了没必要做的事情,属于浪费资源。
针对这个问题,我们可以设定一个临时遍历来标记该数组是否已经有序。如果在本轮排序中,元素有交换,则说明数列无序;如果没有元素交换,则说明数列已然有序,然后直接跳出大循环。
// 优化一:有序标记,提前退出
// 最好情况(数组本身有序)时间复杂度降到 O(n),最坏和平均仍是 O(n²)
function bubbleSort(arr) {
  const len = arr.length;
  for (let i = 0; i < len; i++) {
    // 有序标记,每一轮的初始值都是 true
    let isSort = true;
    for (let j = 0; j < len - 1 - i; j++) {
      if (arr[j] > arr[j + 1]) {
        swap(arr, j, j + 1);
        // 有元素交换,说明还无序,标记变为 false
        isSort = false;
      }
    }
    // 一整轮下来没有发生任何交换,说明数组已经有序,直接跳出大循环
    if (isSort) {
      break;
    }
  }
  return arr;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
📌 优化点二
以上只是冒泡排序优化的第一步,我们还可以进一步来提升它的性能。
比如有一个新的数组:
3, 4, 2, 1, 5, 6, 7, 8
这个数组的特点是前半部分的元素(3、4、2、1)无序,后半部分的元素(5、6、7、8)按升序排列,并且后半部分元素中的最小值也大于前半部分元素的最大值。
其实这个数组右面的许多元素已经是有序的了,可是如果按照现在的冒泡排序,每一轮还是白白地比较了许多次。这正是冒泡排序中另一个需要优化的点。
这个问题的关键点在于对数组有序区的界定。
那么,该如何避免这种情况呢?我们可以在每一轮排序后,记录下来最后一次元素交换的位置,该位置即为无序数列的边界,再往后就是有序区了。
// 优化二:在优化一的基础上,记录有序区边界,进一步减少无效比较
// 适合 "后半段本来就有序" 的数据;最好情况 O(n),最坏和平均仍是 O(n²)
function bubbleSort(arr) {
  // 记录最后一次交换的位置
  let lastExchangeIndex = 0;
  // 无序数列的边界,每次比较只需要比到这里为止
  let sortBorder = arr.length - 1;
  for (let i = 0; i < arr.length - 1; i++) {
    // 有序标记,每一轮的初始值都是 true
    let isSort = true;
    for (let j = 0; j < sortBorder; j++) {
      if (arr[j] > arr[j + 1]) {
        swap(arr, j, j + 1);
        // 因为有元素进行交换,所以不是有序的,标记变为 false
        isSort = false;
        // 更新为最后一次交换元素的位置。交换发生在 j 和 j+1 之间,较大的元素落在 j+1 上,
        // 本轮 j+1 之后再没发生过交换,说明从 j+1 开始到末尾都是有序区,所以无序区边界取 j+1
        lastExchangeIndex = j + 1;
      }
    }
    // 最后一次交换的位置之后再没发生过交换,说明后面都是有序区,下一轮只比到这里
    sortBorder = lastExchangeIndex;
    // 一整轮下来没有发生任何交换,说明数组已经有序,直接跳出大循环
    if (isSort) {
      break;
    }
  }
  return arr;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
在这一版代码中,sortBorder 就是无序数列的边界。在每一轮排序过程中,处于 sortBorder 之后的元素就不需要再进行比较了,肯定是有序的。
# 鸡尾酒排序
鸡尾酒排序是基于冒泡排序的一种升级排序算法。
# 鸡尾酒排序的思路
鸡尾酒排序的元素比较和交换过程是双向的。
下面举一个例子。
由 8 个数字组成一个无序数列{2,3,4,5,6,7,8,1},希望对其进行从小到大的排序。
如果按照冒泡排序的思想,排序过程如下。
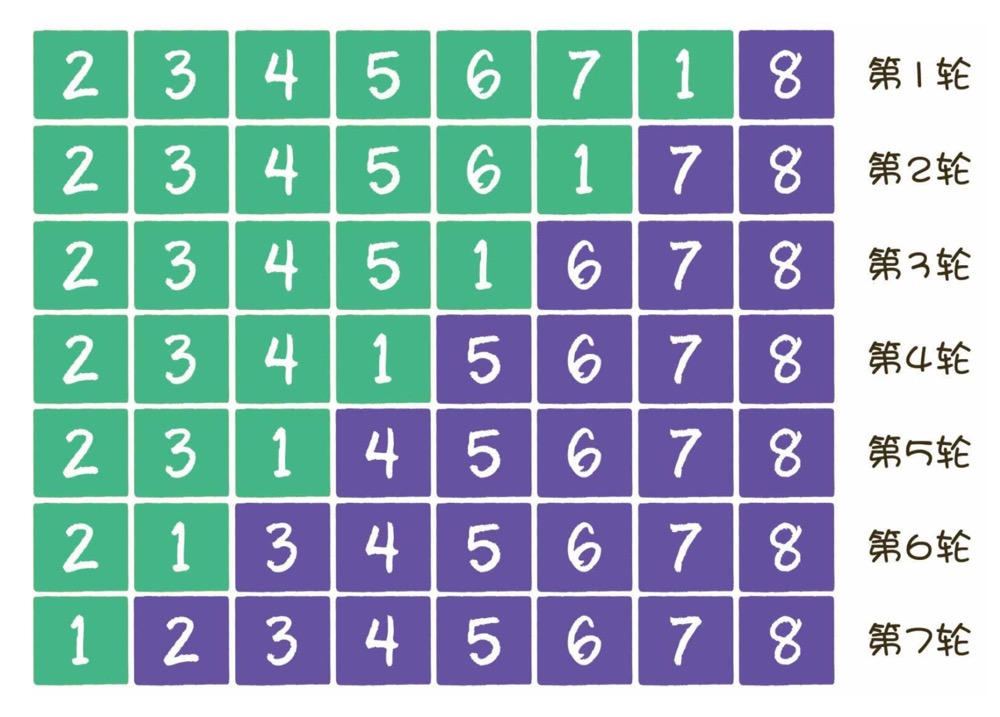
元素 2、3、4、5、6、7、8 已经是有序的了,只有元素 1 的位置不对,却还要进行 7 轮排序。
鸡尾酒排序正是要解决这个问题。
如果按照鸡尾酒排序,详细过程如下。
第 1 轮(和冒泡排序一样,8 和 1 交换)
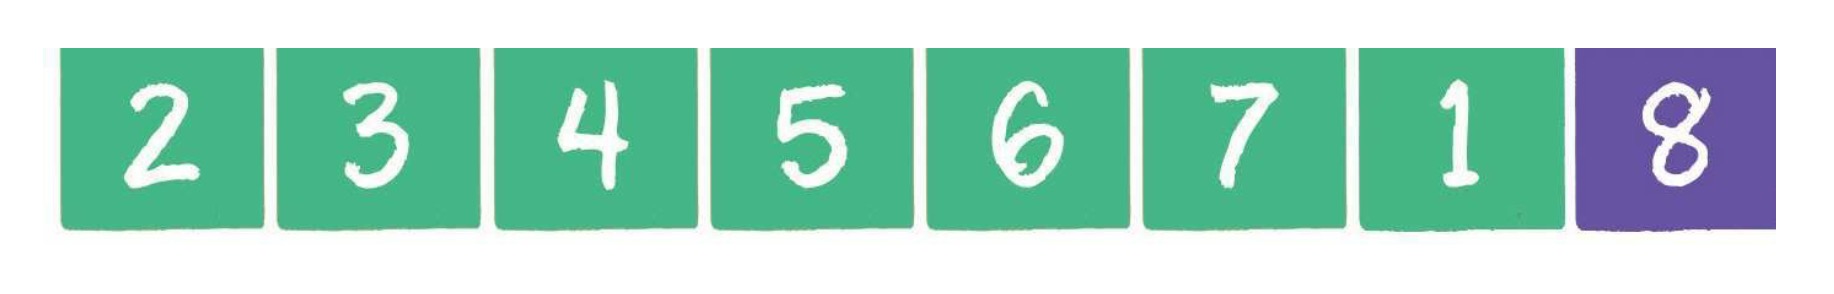
第 2 轮
此时开始不一样了,我们反过来从右往左比较并进行交换。
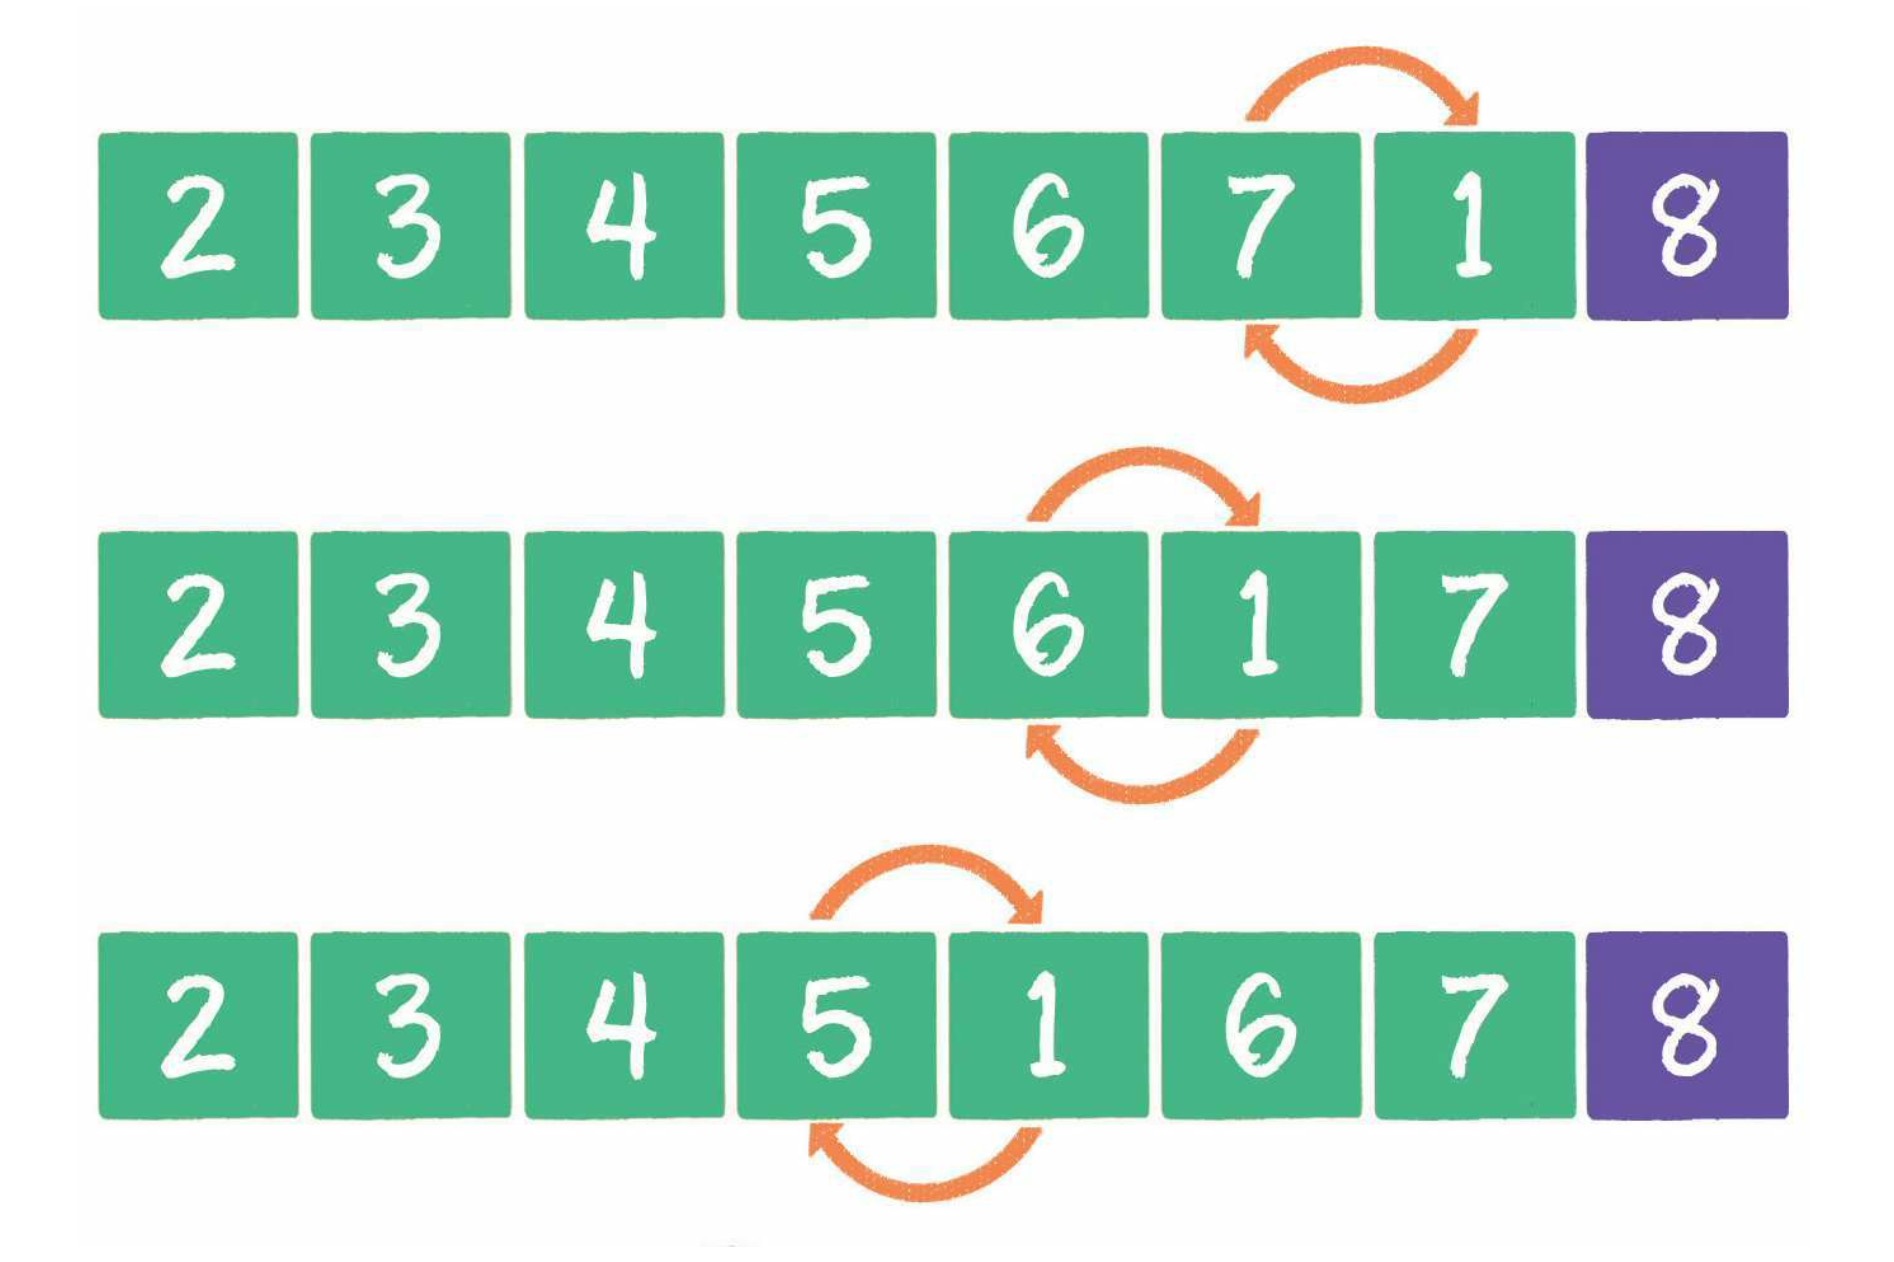
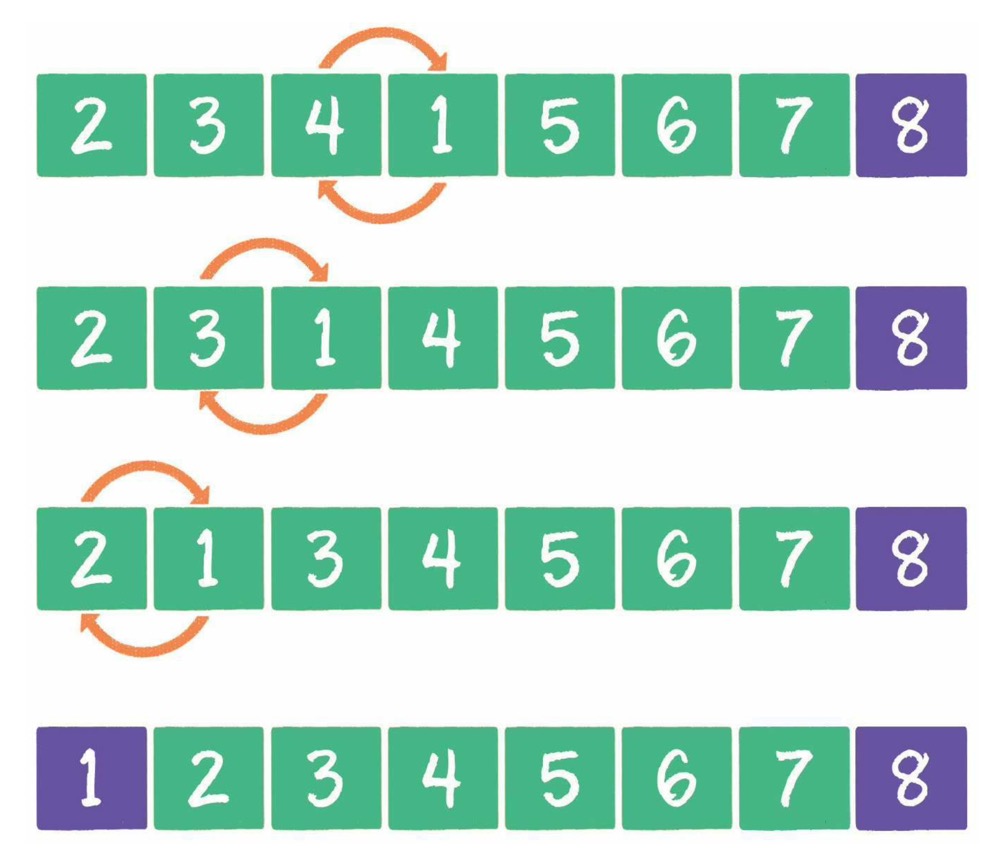
第 3 轮(虽然实际上已经有序,但是流程并没有结束)
在鸡尾酒排序的第 3 轮,需要重新从左向右比较并进行交换。
1 和 2 比较,位置不变;2 和 3 比较,位置不变;3 和 4 比较,位置不变......6 和 7 比较,位置不变。
没有元素位置进行交换,证明已经有序,排序结束。
这就是鸡尾酒排序的思路。排序过程就像钟摆一样,第 1 轮从左到右,第 2 轮从右到左,第 3 轮再从左到右......
这样,本来要用 7 轮排序的场景,用 3 轮就解决了。
# 鸡尾酒排序的实现
function swap(arr, i, j) {
  const temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

function cocktailSort(arr) {
  const len = arr.length;
  for (let i = 0; i < len / 2; i++) {
    // 有序标记,每一轮的初始值都是 true
    let isSort = true;
    // 奇数轮,从左向右比较和交换
    for (let j = i; j < len - 1 - i; j++) {
      if (arr[j] > arr[j + 1]) {
        swap(arr, j, j + 1);
        // 有元素交换,所以不是有序的,标记变为 false
        isSort = false;
      }
    }
    if (isSort) {
      break;
    }
    // 在偶数轮之前,将 isSort 重新标记为 true
    isSort = true;
    // 偶数轮,从右向左比较和交换
    for (let j = len - 1 - i; j > i; j--) {
      if (arr[j] < arr[j - 1]) {
        swap(arr, j, j - 1);
        // 因为有元素进行交换,所以不是有序的,标记变为 false
        isSort = false;
      }
    }
    if (isSort) {
      break;
    }
  }
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
这段代码是鸡尾酒排序的原始实现。代码外层的大循环控制着所有排序回合,大循环内包含 2 个小循环,第 1 个小循环从左向右比较并交换元素,第 2 个小循环从右向左比较并交换元素。
# 鸡尾酒排序的适用场景
鸡尾酒排序的优点是能够在特定条件下,减少排序的回合数;而缺点也很明显,就是代码量几乎增加了 1 倍。
因此,鸡尾酒排序能发挥出优势的场景,就是大部分元素已经有序的情况。
# 选择排序 ✅
# 选择排序的思路
首先,找到数组中最小的元素,拎出来,将它和数组的第一个元素交换位置,第二步,在剩下的元素中继续寻找最小的元素,拎出来,和数组的第二个元素交换位置,如此循环,直到整个数组排序完成。
至于选大还是选小,这个都无所谓,你也可以每次选择最大的拎出来排,也可以每次选择最小的拎出来的排,只要你的排序的手段是这种方式,都叫选择排序。
# 选择排序的实现
// 交换数组中下标 i 和 j 的两个元素
function swap(arr, i, j) {
  const temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

// 时间复杂度是 O(n²),比较次数固定是 n(n-1)/2,最好、最坏、平均都一样,和数据是否有序无关
// 空间复杂度是 O(1),原地排序
// 不稳定排序:跨距离交换会破坏相等元素的相对次序,例如 [5a, 5b, 2] 第一轮后变成 [2, 5b, 5a]
function selectionSort(arr) {
  if (arr.length < 2) {
    return arr;
  }
  const len = arr.length;
  // [0, i) 是已排序区,[i, len) 是未排序区,每轮把未排序区的最小值放到位置 i
  // 只需 len - 1 轮,前 n-1 个都就位后,最后一个元素自动就位
  for (let i = 0; i < len - 1; i++) {
    let min = i; // 先假设当前位置就是最小值
    // 内层只比较、不交换,用 min 记住未排序区最小值的下标。
    // 如果边比边换,一轮里会产生很多次无谓的交换(最坏 O(n²) 次);
    // 先扫完确定最小值在哪,再做唯一一次必要的交换,总交换次数就能控制在 n-1 次以内
    for (let j = i + 1; j < len; j++) {
      if (arr[j] < arr[min]) {
        min = j;
      }
    }
    // 一整轮扫描结束后,一次性把最小值换到位置 i,所以交换次数最多 n-1 次
    swap(arr, i, min);
  }
  return arr;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
# 插入排序 ✅
# 插入排序的思路
插入排序的思想和我们打扑克摸牌的时候一样,从牌堆里一张一张摸起来的牌都是乱序的,我们会把摸起来的牌插入到左手中合适的位置,让左手中的牌时刻保持一个有序的状态。
实现时会把数组分为已排序和未排序两部分,第一个数为已排序,其余为未排序。然后从未排序抽出第一个数,和已排序部分比较,插入到合适的位置。重复此操作直到数组排序完成。
# 插入排序的实现
// 插入排序:将数组分成左侧已排序区和右侧未排序区,
// 每轮取出未排序区的第一个元素,将它插入已排序区的合适位置。
// 最好时间复杂度 O(n),平均和最坏时间复杂度 O(n²),空间复杂度 O(1)。
function insertionSort(arr) {
  if (arr.length < 2) {
    return arr;
  }

  // 下标 0 可以看作初始的已排序区,所以从下标 1 开始处理
  for (let i = 1; i < arr.length; i++) {
    // 暂存当前待插入的元素,防止后续右移元素时将它覆盖
    const value = arr[i];
    let j = 0;

    // 从已排序区末尾向前查找插入位置
    // 凡是比 value 大的元素,都向右移动一位,为 value 腾出位置
    for (j = i - 1; j >= 0 && arr[j] > value; j--) {
      arr[j + 1] = arr[j];
    }

    // 循环结束后,j + 1 就是 value 应该插入的位置
    // 条件使用 > 而不是 >=,相等元素不会交换位置,因此排序是稳定的
    arr[j + 1] = value;
  }

  return arr;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
# 希尔排序
# 希尔排序的思路
希尔排序这个名字,来源于它的发明者希尔,也称作“缩小增量排序”,是插入排序的一种更高效的改进版本。它通过定义一个间隔序列来表示在排序过程中进行比较的元素间隔。
我们知道,插入排序对于大规模的乱序数组的时候效率是比较慢的,因为它每次只能将数据移动一位,希尔排序为了加快插入的速度,让数据移动的时候可以实现跳跃移动,节省了一部分的时间开支。当区间为 1 的时候,它使用的排序方式就是插入排序。
# 希尔排序的实现
function shellSort(arr) {
  const len = arr.length;
  let gap = 1;
  while (gap < len) {
    gap = gap * 3 + 1;
  }
  while (gap > 0) {
    for (let i = gap; i < len; i++) {
      const temp = arr[i];
      let j = i - gap;
      // 跨区间排序
      while (j >= 0 && arr[j] > temp) {
        arr[j + gap] = arr[j];
        j -= gap;
      }
      arr[j + gap] = temp;
    }
    gap = Math.floor(gap / 3);
  }
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
可能你会问为什么区间要以 gap = gap*3 + 1 去计算,其实最优的区间计算方法是没有答案的,这是一个长期未解决的问题,不过差不多都会取在二分之一到三分之一附近。
# 归并排序(合并排序)✅
# 归并排序的思路
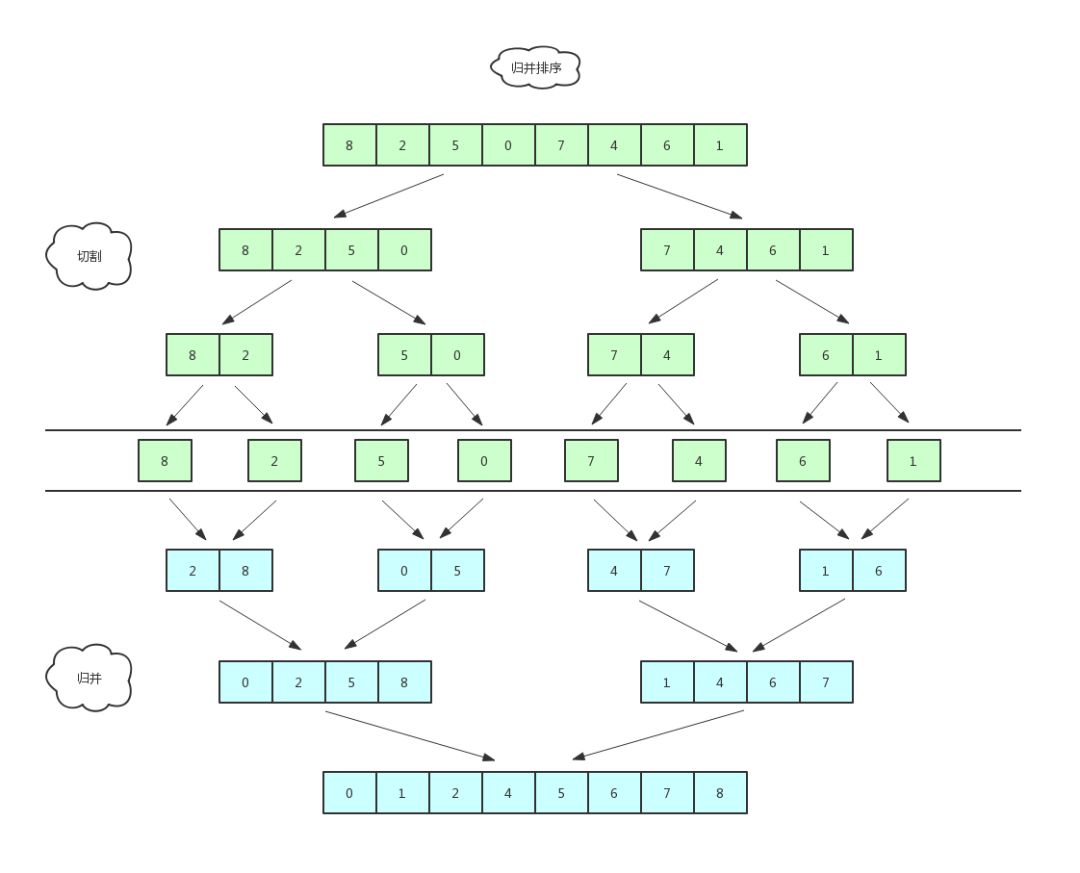
归并算法的核心思想是分治法,就是将一个数组一刀切两半,递归切,直到切成单个元素,然后重新组装合并,单个元素合并成小数组,两个小数组合并成大数组,直到最终合并完成,排序完毕。
# 归并排序的实现
// 时间复杂度是 O(nlogn),空间复杂度是 O(n)
function mergeSort(arr) {
  // 空数组或只有一个元素的数组本身就是有序的,也是递归的终止条件
  if (arr.length < 2) {
    return arr;
  }

  // 从中间将数组拆分成左右两部分;slice 不会修改原数组
  const middle = Math.floor(arr.length / 2);
  const leftArr = arr.slice(0, middle);
  const rightArr = arr.slice(middle);

  // 分别递归排序左右两部分,再合并两个有序数组
  return merge(mergeSort(leftArr), mergeSort(rightArr));
}

// 使用双指针合并两个有序数组
function merge(leftArr, rightArr) {
  // 存放合并结果,因此该实现不是原地排序
  const res = [];
  let l = 0,
    r = 0;

  // 比较两个指针指向的元素,每次将较小者放入结果数组
  while (l < leftArr.length && r < rightArr.length) {
    // 相等时优先取左侧元素,以保持相等元素原有的相对顺序
    if (leftArr[l] <= rightArr[r]) {
      res.push(leftArr[l]);
      l++;
    } else {
      res.push(rightArr[r]);
      r++;
    }
  }

  // 循环结束后,至少有一侧已经处理完,直接追加另一侧的剩余元素
  return res.concat(leftArr.slice(l)).concat(rightArr.slice(r));
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
// 时间复杂度是 O(nlogn),空间复杂度是 O(n)
// 注意:JavaScript 数组的 shift() 可能需要移动后续元素,频繁调用会影响实际性能
function mergeSort(arr) {
  // 空数组或只有一个元素的数组本身就是有序的,也是递归的终止条件
  if (arr.length < 2) {
    return arr;
  }

  // 从中间将数组拆分成左右两部分;slice 不会修改原数组
  const middle = Math.floor(arr.length / 2);
  const leftArr = arr.slice(0, middle);
  const rightArr = arr.slice(middle);

  // 分别递归排序左右两部分,再合并成一个有序数组
  return merge(mergeSort(leftArr), mergeSort(rightArr));
}

// 合并两个已经有序的数组
function merge(leftArr, rightArr) {
  // 保存最终的合并结果
  const res = [];

  // 两侧都有元素时,比较各自的第一个元素,将较小者放入结果数组
  while (leftArr.length && rightArr.length) {
    if (leftArr[0] <= rightArr[0]) {
      res.push(leftArr.shift());
    } else {
      res.push(rightArr.shift());
    }
  }

  // 右侧处理完后,将左侧剩余的有序元素依次追加到结果中
  while (leftArr.length) {
    res.push(leftArr.shift());
  }

  // 左侧处理完后,将右侧剩余的有序元素依次追加到结果中
  while (rightArr.length) {
    res.push(rightArr.shift());
  }

  // 返回合并完成的新数组
  return res;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
# 快速排序 ✅
# 快速排序的思路
快速排序的核心思想也是分治法,分而治之。它的实现方式是每次从序列中选出一个基准值(可以随机选取),其他数依次和基准值做比较,比基准值大的放右边,比基准值小的放左边,然后再对左边和右边的两组数分别选出一个基准值,进行同样的比较移动,重复步骤,直到最后都变成单个元素,整个数组就成了有序的序列。
基准元素的选择,以及元素的交换,都是快速排序的核心问题。
基准元素的选择最简单的可以选择数组的第 1 个元素。元素的交换方法有双边循环法和单边循环法两种。
# 基准元素的选择
最简单的方式是选择数列的第 1 个元素。
这种选择在绝大多数情况下是没有问题的。但是,假如有一个原本逆序的数列,期望排序成顺序数列,那么会出现什么情况呢?
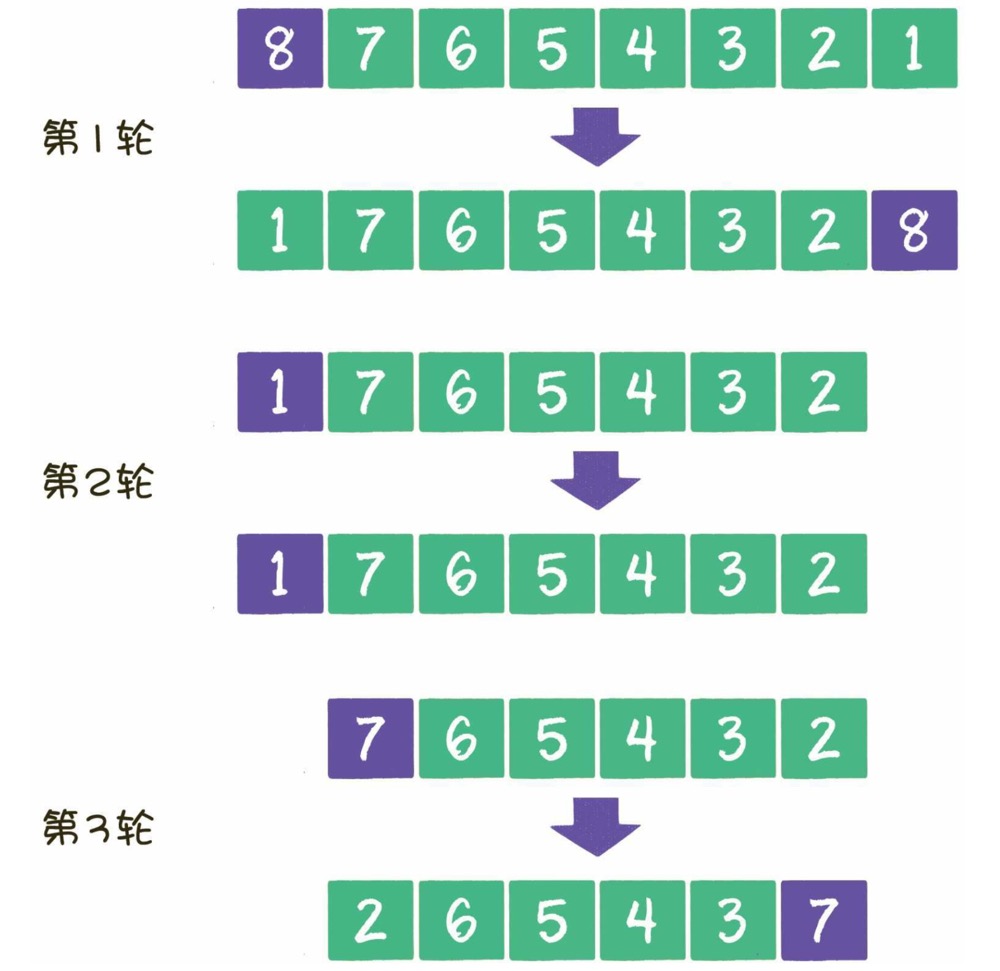
我们会发现,整个数列并没有被分成两半,每一轮都只确定了基准元素的位置。
在这种情况下,数列的第 1 个元素要么是最小值,要么是最大值,根本无法发挥分治法的优势。
在这种极端情况下,快速排序需要进行 n 轮,时间复杂度退化成了 O(n^2)。
那么,该怎么避免这种情况发生呢?
其实很简单,我们可以随机选择一个元素作为基准元素,并且让基准元素和数列首元素交换位置。
这样一来,即使在数列完全逆序的情况下,也可以有效地将数列分成两部分。
当然,即使是随机选择基准元素,也会有极小的几率选到数列的最大值或最小值,同样会影响分治的效果。
所以,虽然快速排序的平均时间复杂度是 O(nlogn),但最坏情况下的时间复杂度是 O(n^2)。
# 快速排序的简单实现
// 选择第一个元素作为基准值
// 时间复杂度:平均 O(nlogn),最坏 O(n²);空间复杂度:平均 O(n),最坏 O(n²)
function quickSort(arr) {
  // 递归出口:空数组或单个元素已经有序
  if (arr.length < 2) {
    return arr;
  }

  const pivot = arr[0];
  const left = [],
    right = [];

  // 小于基准值的放左边,其余元素放右边
  for (let i = 1; i < arr.length; i++) {
    if (arr[i] < pivot) {
      left.push(arr[i]);
    } else {
      right.push(arr[i]);
    }
  }

  // 递归排序左右两部分,再和基准值拼接
  return quickSort(left).concat(pivot, quickSort(right));
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
// 选择中间位置的元素作为基准值,可以降低有序数组划分失衡的概率
// 时间复杂度:平均 O(nlogn),最坏 O(n²);空间复杂度:平均 O(n),最坏 O(n²)
function quickSort(arr) {
  // 递归出口:空数组或单个元素已经有序
  if (arr.length < 2) {
    return arr;
  }

  const pivotIndex = Math.floor(arr.length / 2);
  // 取出基准值;splice 会修改传入的数组
  const pivot = arr.splice(pivotIndex, 1)[0];
  const left = [],
    right = [];

  // 小于基准值的放左边,其余元素放右边
  for (let i = 0; i < arr.length; i++) {
    if (arr[i] < pivot) {
      left.push(arr[i]);
    } else {
      right.push(arr[i]);
    }
  }

  // 递归排序左右两部分,再和基准值拼接
  return quickSort(left).concat(pivot, quickSort(right));
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
# 双边循环法的思路
给出原始数列如下,要求对其从小到大进行排序。
4,7,6,5,3,2,8,1
首先,选定基准元素 pivot,并且设置两个指针 left 和 right,指向数列的最左和最右两个元素。
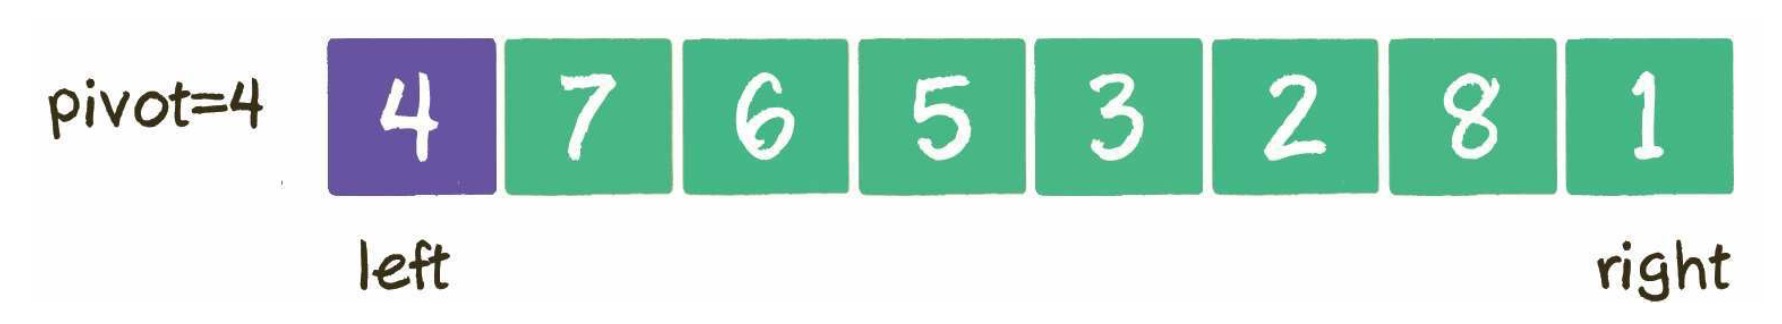
接下来进行第 1 次循环,从 right 指针开始,让指针所指向的元素和基准元素做比较。如果大于或等于 pivot,则指针向左移动;如果小于 pivot,则 right 指针停止移动,切换到 left 指针。
在当前数列中,1 < 4,所以 right 直接停止移动,换到 left 指针,进行下一步行动。
轮到 left 指针行动,让指针所指向的元素和基准元素做比较。如果小于或等于 pivot,则指针向右移动;如果大于 pivot,则 left 指针停止移动。
由于 left 开始指向的是基准元素,判断肯定相等,所以 left 右移 1 位。
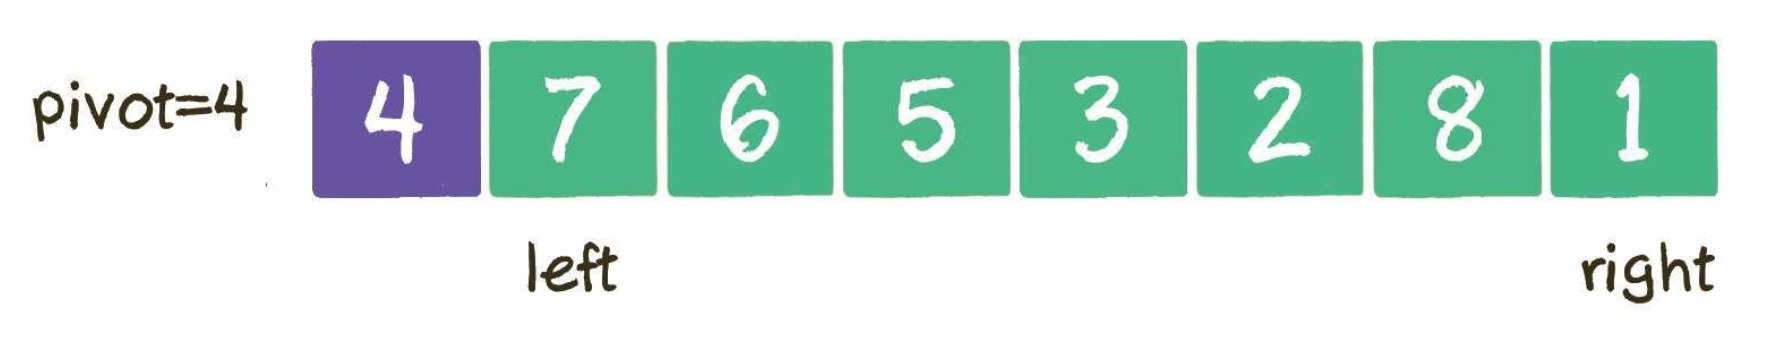
由于 7 > 4,left 指针在元素 7 的位置停下。这时,让 left 和 right 指针所指向的元素进行交换。
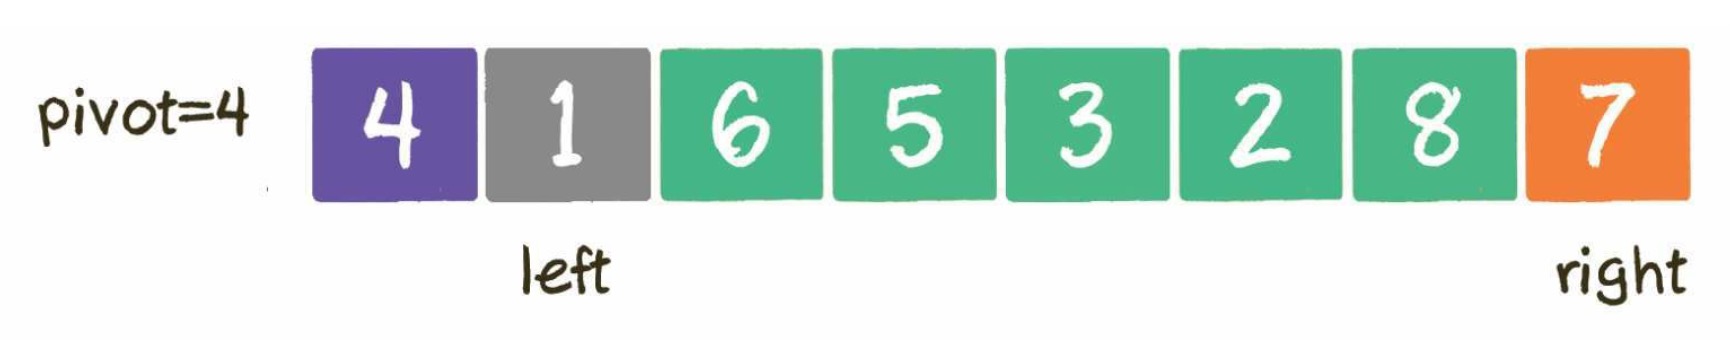
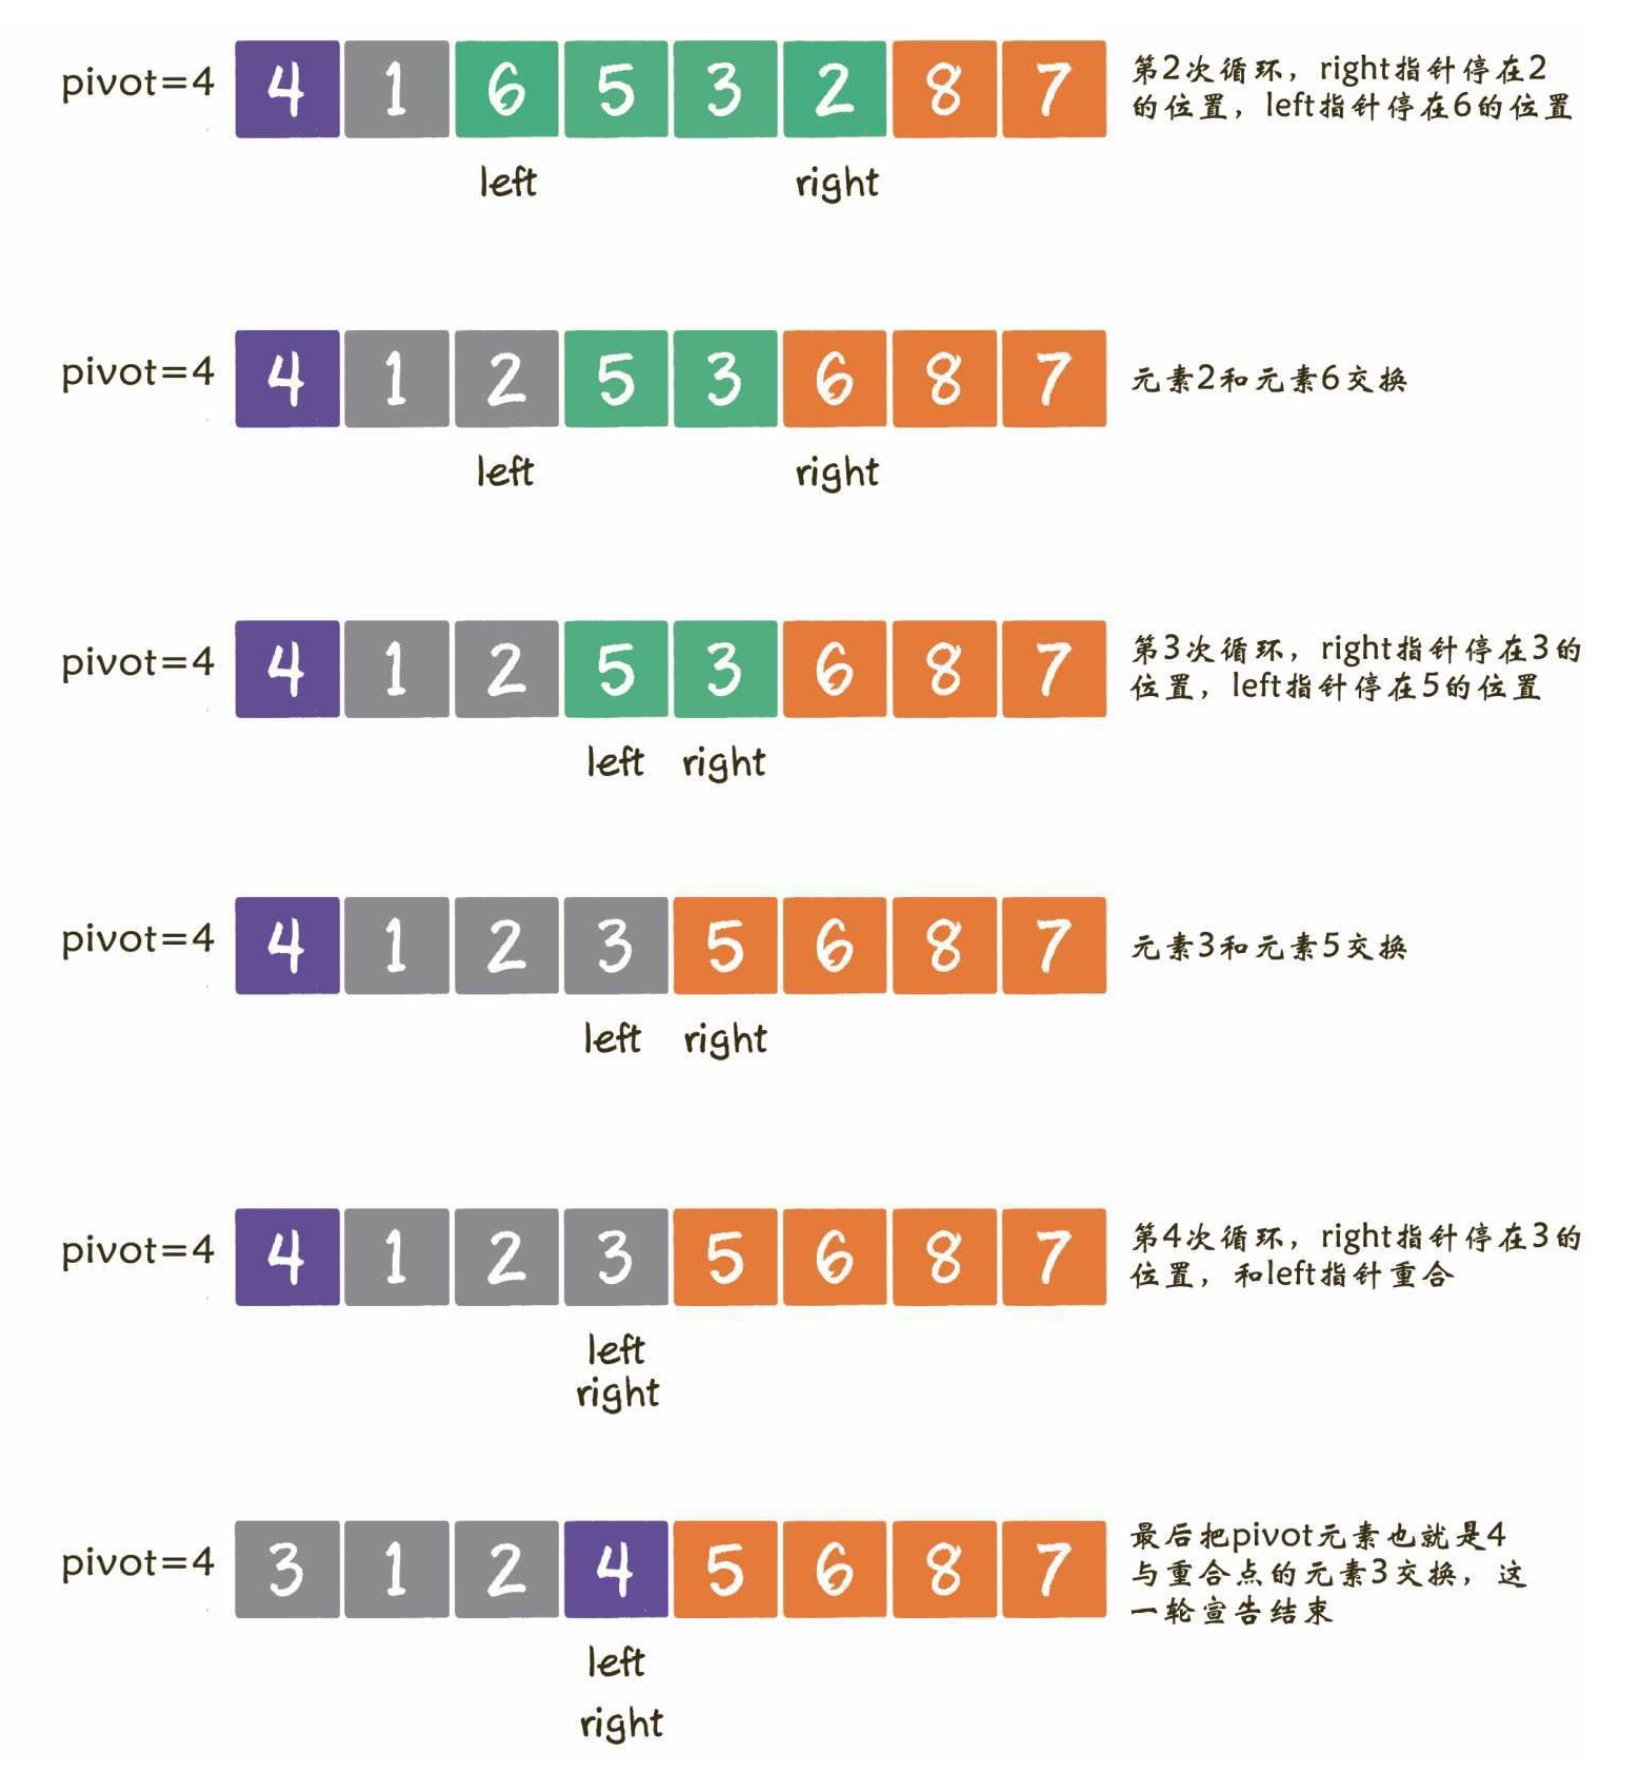
接下来,进入第 2 次循环,重新切换到 right 指针,向左移动。right 指针先移动到 8,8>4,继续左移。由于 2<4,停止在 2 的位置。
按照这个思路,后续步骤如图所示。
# 双边循环法的实现
function quickSort(arr, startIndex, endIndex) {
  // 递归结束条件: startIndex 大于或等于 endIndex 时
  if (startIndex >= endIndex) {
    return;
  }
  // 得到基准元素位置
  const pivotIndex = partition(arr, startIndex, endIndex);
  // 根据基准元素,分成两部分进行递归排序
  quickSort(arr, startIndex, pivotIndex - 1);
  quickSort(arr, pivotIndex + 1, endIndex);
}

/*
 * 分治(双边循环法)
 * @param arr 待交换的数组
 * @param startIndex 起始下标
 * @param endIndex 结束下标
 */
function partition(arr, startIndex, endIndex) {
  // 取第1个位置(也可以选择随机位置)的元素作为基准元素
  const pivot = arr[startIndex];
  let left = startIndex;
  let right = endIndex;

  while (left !== right) {
    // 控制 right 指针比较并左移
    while (left < right && arr[right] > pivot) {
      right--;
    }
    // 控制 left 指针比较并右移
    while (left < right && arr[left] <= pivot) {
      left++;
    }
    // 交换 left 和 right 指针所指向的元素
    if (left < right) {
      const temp = arr[left];
      arr[left] = arr[right];
      arr[right] = temp;
    }
  }

  // pivot 和指针重合点交换
  arr[startIndex] = arr[left];
  arr[left] = pivot;
  return left;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
# 单边循环法的思路
给出原始数列如下,要求对其从小到大进行排序。
4,7,6,5,3,2,8,1
开始和双边循环法相似,首先选定基准元素 pivot。同时,设置一个 mark 指针指向数列起始位置,这个 mark 指针代表小于基准元素的区域边界。
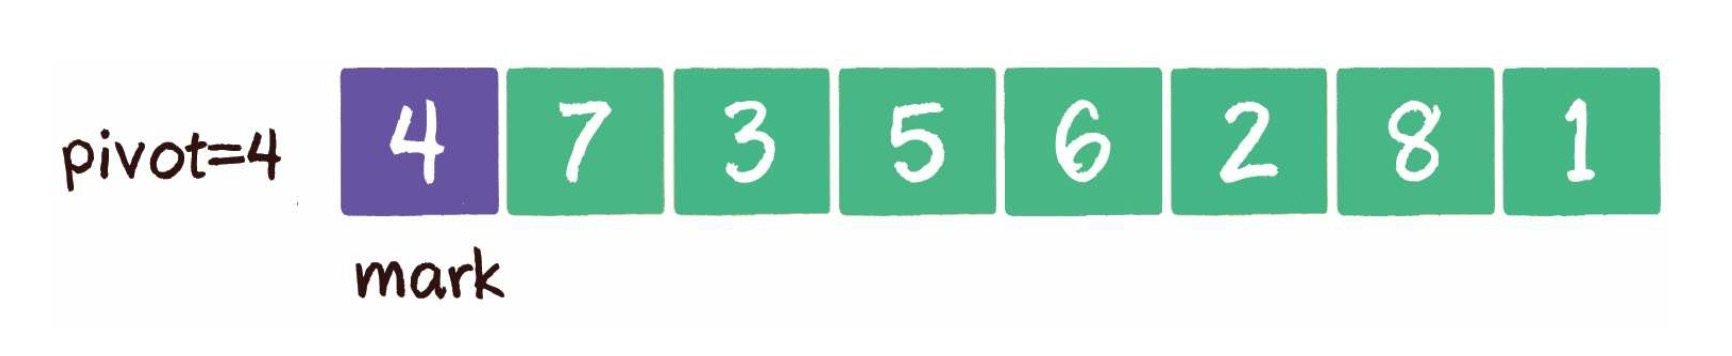
接下来,从基准元素的下一个位置开始遍历数组。
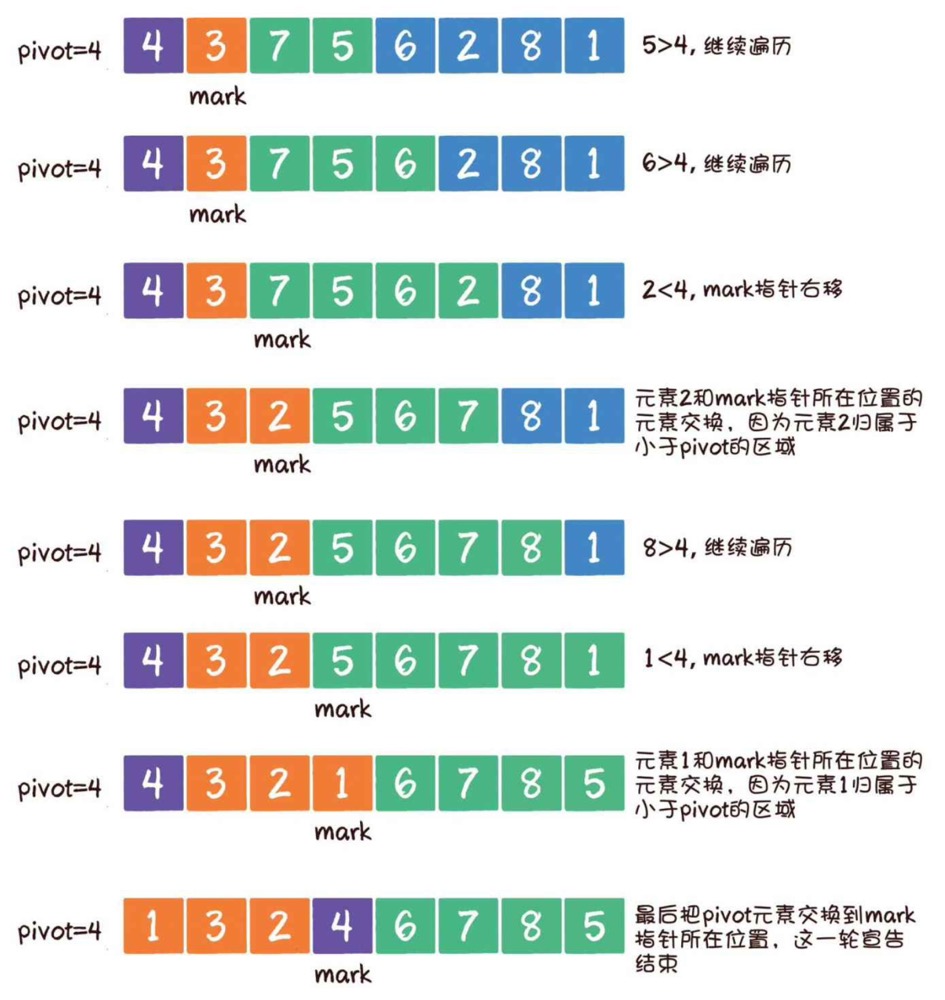
如果遍历到的元素大于基准元素,就继续往后遍历。
如果遍历到的元素小于基准元素,则需要做两件事:第一,把 mark 指针右移 1 位,因为小于 pivot 的区域边界增大了 1;第二,让最新遍历到的元素和 mark 指针所在位置的元素交换位置,因为最新遍历的元素归属于小于 pivot 的区域。
首先遍历到元素 7,7>4,所以继续遍历。
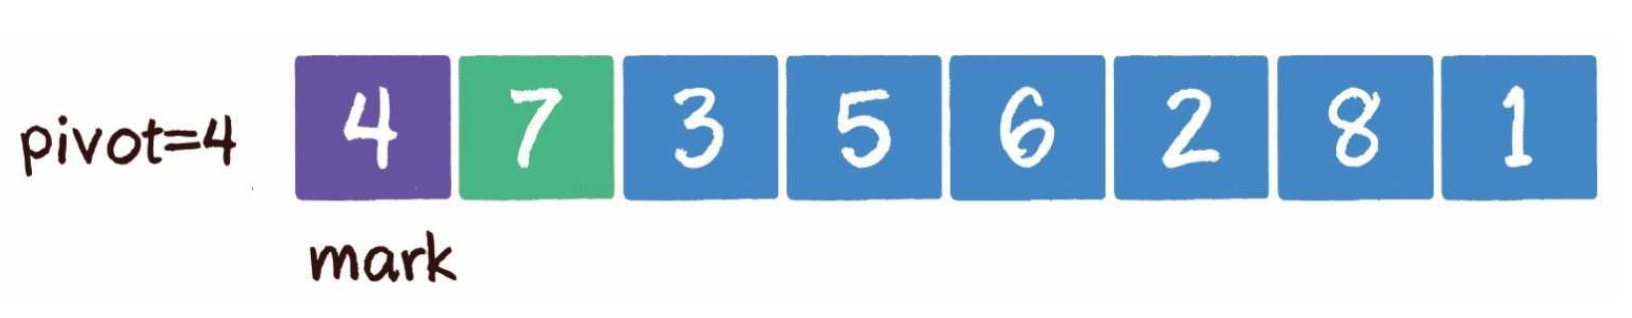
接下来遍历到的元素是 3,3<4,所以 mark 指针右移 1 位。
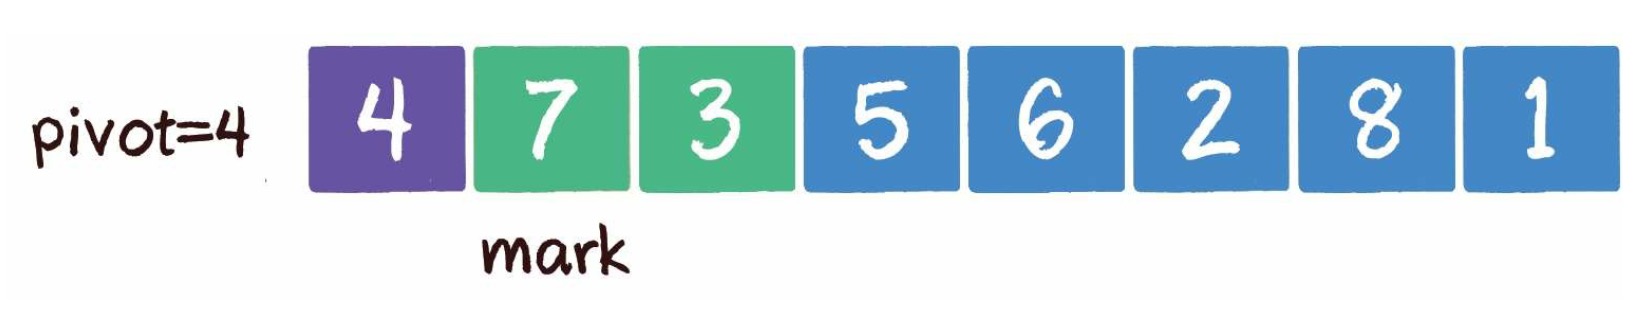
随后,让元素 3 和 mark 指针所在位置的元素交换,因为元素 3 归属于小于 pivot 的区域。
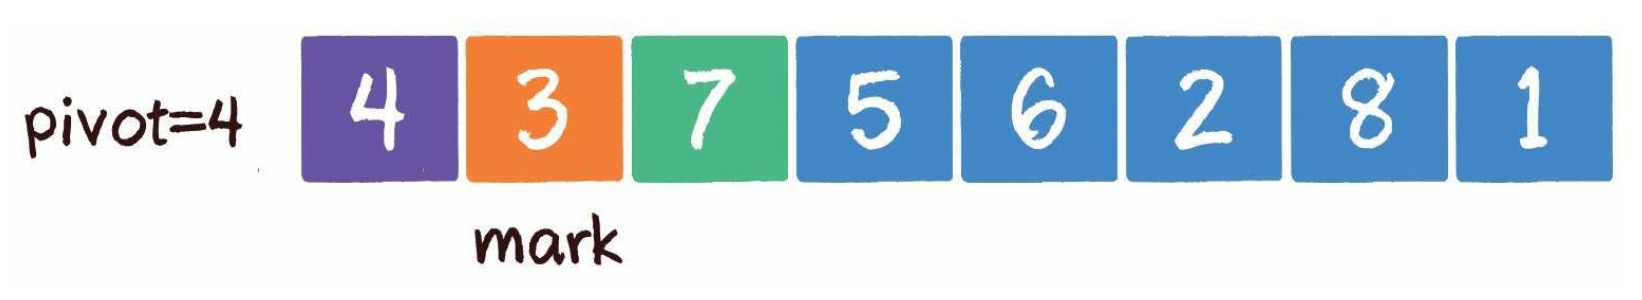
按照这个思路,继续遍历,后续步骤如图所示。
# 单边循环法的实现
单边循环法和双边循环法的区别在于 partition 函数的实现。
function quickSort(arr, startIndex, endIndex) {
  // 递归结束条件: startIndex 大于或等于 endIndex 时
  if (startIndex >= endIndex) {
    return;
  }
  // 得到基准元素位置
  const pivotIndex = partition(arr, startIndex, endIndex);
  // 根据基准元素,分成两部分进行递归排序
  quickSort(arr, startIndex, pivotIndex - 1);
  quickSort(arr, pivotIndex + 1, endIndex);
}

/*
 * 分治(单边循环法)
 * @param arr 待交换的数组
 * @param startIndex 起始下标
 * @param endIndex 结束下标
 */
function partition(arr, startIndex, endIndex) {
  // 取第1个位置(也可以选择随机位置)的元素作为基准元素
  const pivot = arr[startIndex];
  let mark = startIndex;

  for (let i = startIndex + 1; i <= endIndex; i++) {
    if (arr[i] < pivot) {
      mark++;
      const temp = arr[mark];
      arr[mark] = arr[i];
      arr[i] = temp;
    }
  }

  arr[startIndex] = arr[mark];
  arr[mark] = pivot;
  return mark;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
# 单边循环法的非递归实现
绝大多数的递归逻辑,都可以用栈的方式来代替。
代码中一层一层的方法调用,本身就使用了一个方法调用栈。每次进入一个新方法,就相当于入栈;每次有方法返回,就相当于出栈。
所以,可以把原本的递归实现转化成一个栈的实现,在栈中存储每一次方法调用的参数。
function quickSort(arr, startIndex, endIndex) {
  // 用一个栈来代替函数的递归栈
  const stack = [];
  // 整个数组的起止下标,以哈希的形式入栈
  const indexMap = new Map();
  indexMap.set("startIndex", startIndex);
  indexMap.set("endIndex", endIndex);
  stack.push(indexMap);

  // 循环结束条件:栈为空时
  while (stack.length) {
    // 栈顶元素出栈,得到起止下标
    const map = stack.pop();
    // 得到基准元素位置
    const pivotIndex = partition(
      arr,
      map.get("startIndex"),
      map.get("endIndex")
    );
    // 根据基准元素分成两部分, 把每一部分的起止下标入栈
    if (map.get("startIndex") < pivotIndex - 1) {
      const leftMap = new Map();
      leftMap.set("startIndex", map.get("startIndex"));
      leftMap.set("endIndex", pivotIndex - 1);
      stack.push(leftMap);
    }
    if (pivotIndex + 1 < map.get("endIndex")) {
      const rightMap = new Map();
      rightMap.set("startIndex", pivotIndex + 1);
      rightMap.set("endIndex", map.get("endIndex"));
      stack.push(rightMap);
    }
  }

  /*
   * 分治(单边循环法)
   * @param arr 待交换的数组
   * @param startIndex 起始下标
   * @param endIndex 结束下标
   */
  function partition(arr, startIndex, endIndex) {
    // 取第1个位置(也可以选择随机位置)的元素作为基准元素
    const pivot = arr[startIndex];
    let mark = startIndex;

    for (let i = startIndex + 1; i <= endIndex; i++) {
      if (arr[i] < pivot) {
        mark++;
        const temp = arr[mark];
        arr[mark] = arr[i];
        arr[i] = temp;
      }
    }

    arr[startIndex] = arr[mark];
    arr[mark] = pivot;
    return mark;
  }
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
# 计数排序
# 计数排序的思路
计数排序、桶排序、基数排序都是不基于元素比较的排序算法。其中,计数排序是利用数组下标来确定元素的正确位置的。
计数排序的基本思路如下:
假设数组中有 20 个随机整数,取值范围为 0~10,要求用最快的速度把这 20 个整数从小到大进行排序。
如何给这些无序的随机整数进行排序呢?
考虑到这些整数只能够在 0、1、2、3、4、5、6、7、8、9、10 这 11 个数中取值,取值范围有限。所以,可以根据这有限的范围,建立一个长度为 11 的数组。数组下标从 0 到 10,元素初始值全为 0。
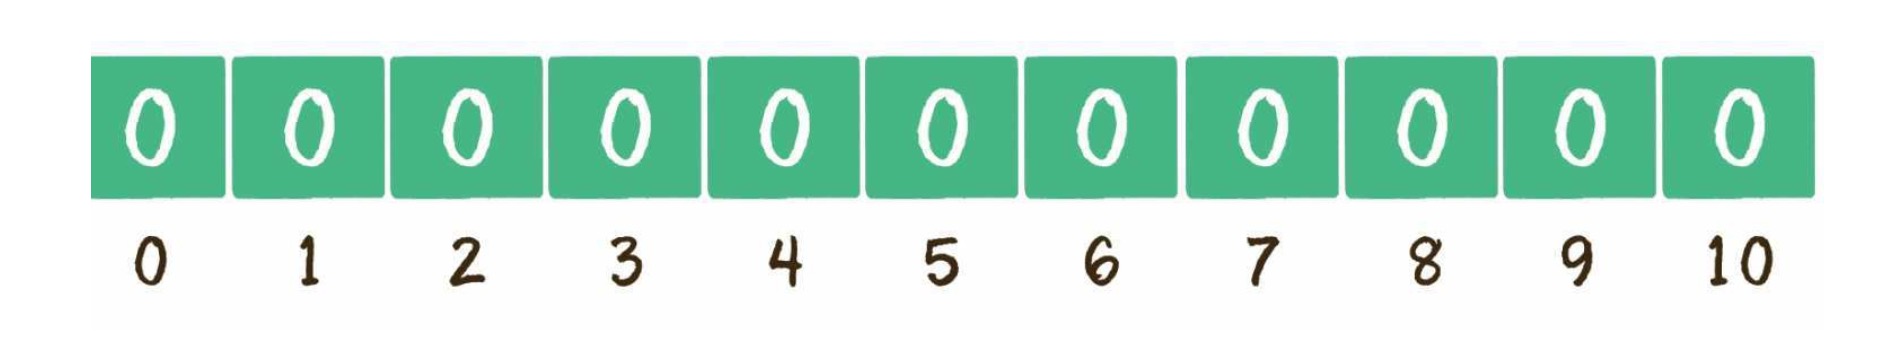
假设 20 个随机整数的值如下所示。
9,3,5,4,9,1,2,7,8,1,3,6,5,3,4,0,10,9,7,9
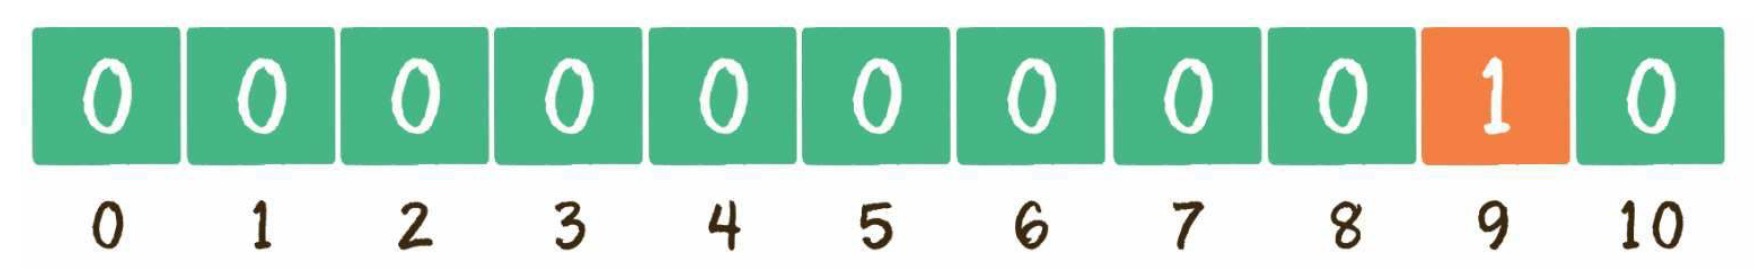
下面就开始遍历这个无序的随机数列,每一个整数按照其值对号入座,同时,对应数组下标的元素进行加 1 操作。
例如第 1 个整数是 9,那么数组下标为 9 的元素加 1。
第 2 个整数是 3,那么数组下标为 3 的元素加 1。
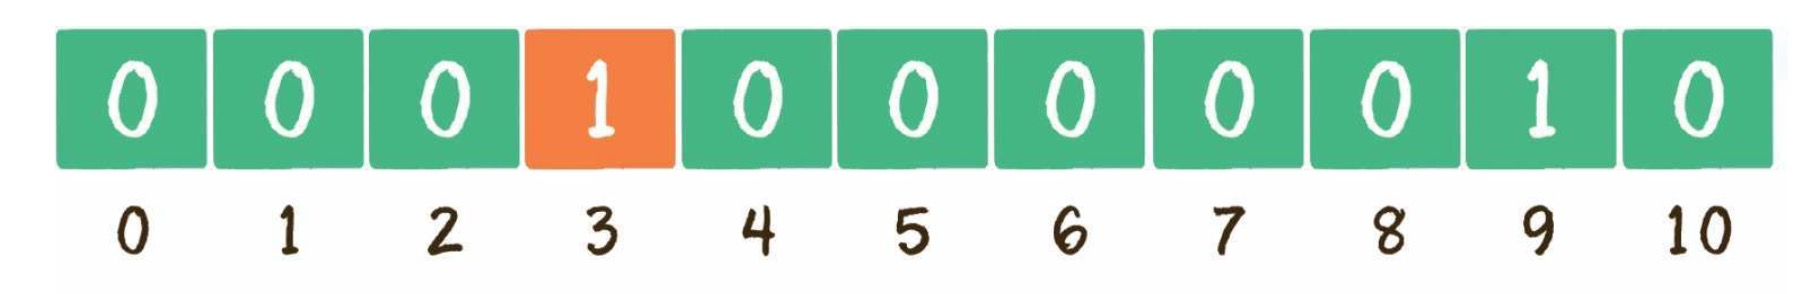
继续遍历数列并修改数组......
最终,当数列遍历完毕时,数组的状态如下。
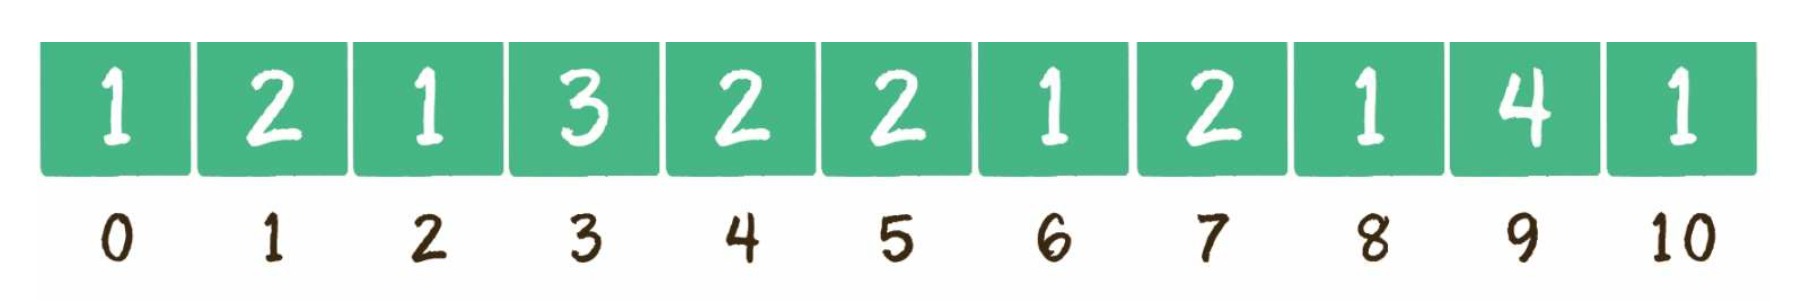
该数组中每一个下标位置的值代表数列中对应整数出现的次数。
有了这个统计结果,排序就很简单了。直接遍历数组,输出数组元素的下标值,元素的值是几,就输出几次。
0,1,1,2,3,3,3,4,4,5,5,6,7,7,8,9,9,9,9,10
显然,现在输出的数列已经是有序的了。
# 计数排序的实现
function countSort(arr) {
  // 1.得到数列的最大值
  let max = arr[0];
  for (let i = 0; i < arr.length; i++) {
    if (arr[i] > max) {
      max = arr[i];
    }
  }
  // 2.根据数列最大值确定统计数组的长度
  const countArr = new Array(max + 1).fill(0);
  // 3.遍历数列,填充统计数组
  for (let i = 0; i < arr.length; i++) {
    countArr[arr[i]]++;
  }
  //4.遍历统计数组,输出结果
  let index = 0;
  for (let i = 0; i < countArr.length; i++) {
    if (countArr[i] > 0) {
      arr[index++] = i;
    }
  }
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
# 计数排序的优化
上述的代码虽然可以实现整数的排序,但是也存在一些问题。
📌 优化点一
问题就在于,我们只以数列的最大值来决定统计数组的长度,这其实并不严谨。比如下面这个例子。
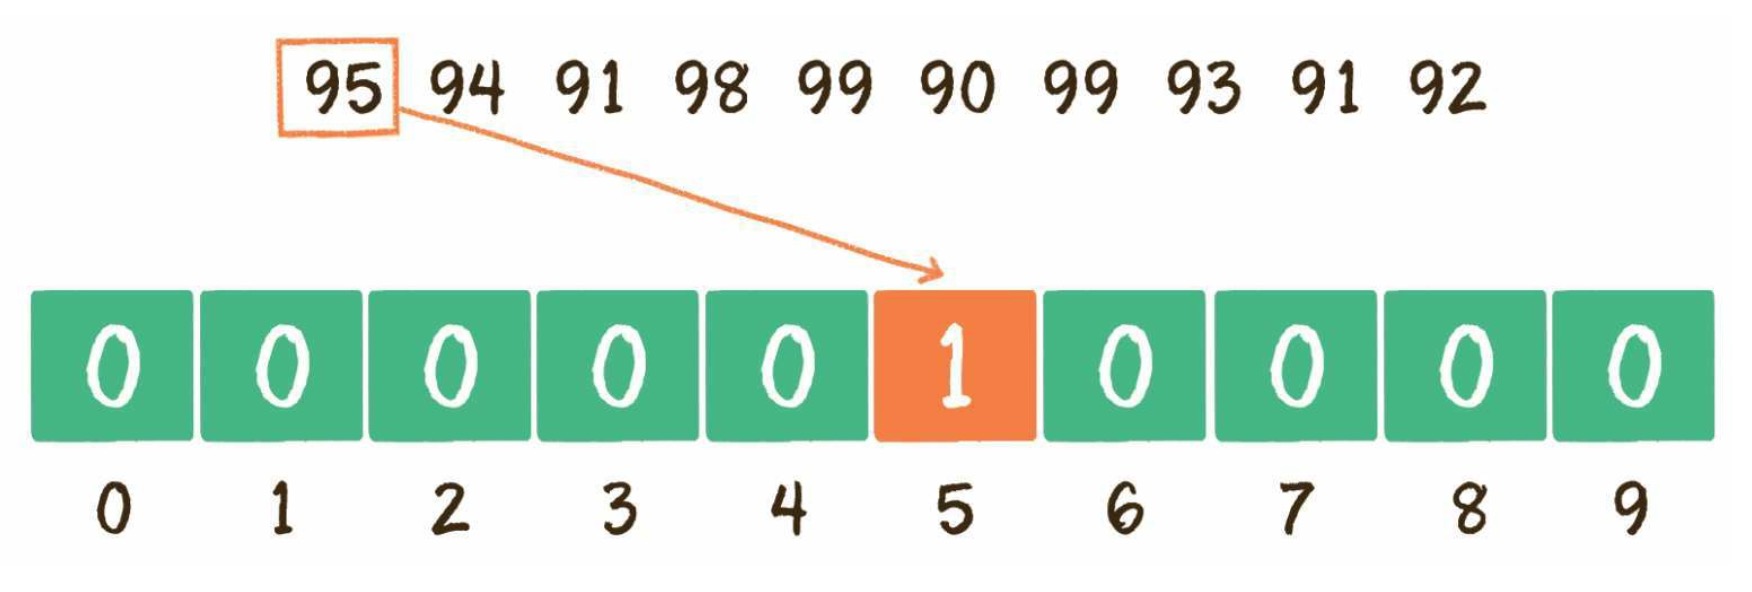
95,94,91,98,99,90,99,93,91,92
这个数列的最大值是 99,但最小的整数是 90。如果创建长度为 100 的数组,那么前面从 0 到 89 的空间位置就都浪费了!
如何解决这个问题呢?
很简单,只要不再以输入数列的最大值+1 作为统计数组的长度,而是以数列最大值-最小值+1作为统计数组的长度即可。
同时,数列的最小值作为一个偏移量,用于计算整数在统计数组中的下标。
以刚才的数列为例,统计出数组的长度为 99-90+1=10,偏移量等于数列的最小值 90。
对于第 1 个整数 95,对应的统计数组下标是 95-90 = 5,如图所示。
这确实对计数排序进行了优化。此外,朴素版的计数排序只是简单地按照统计数组的下标输出元素值,并没有真正给原始数列进行排序。
📌 优化点二
如果只是单纯地给整数排序,这样做并没有问题。但如果在现实业务里,例如给学生的考试分数进行排序,遇到相同的分数就会分不清谁是谁。
比如下面这个例子。
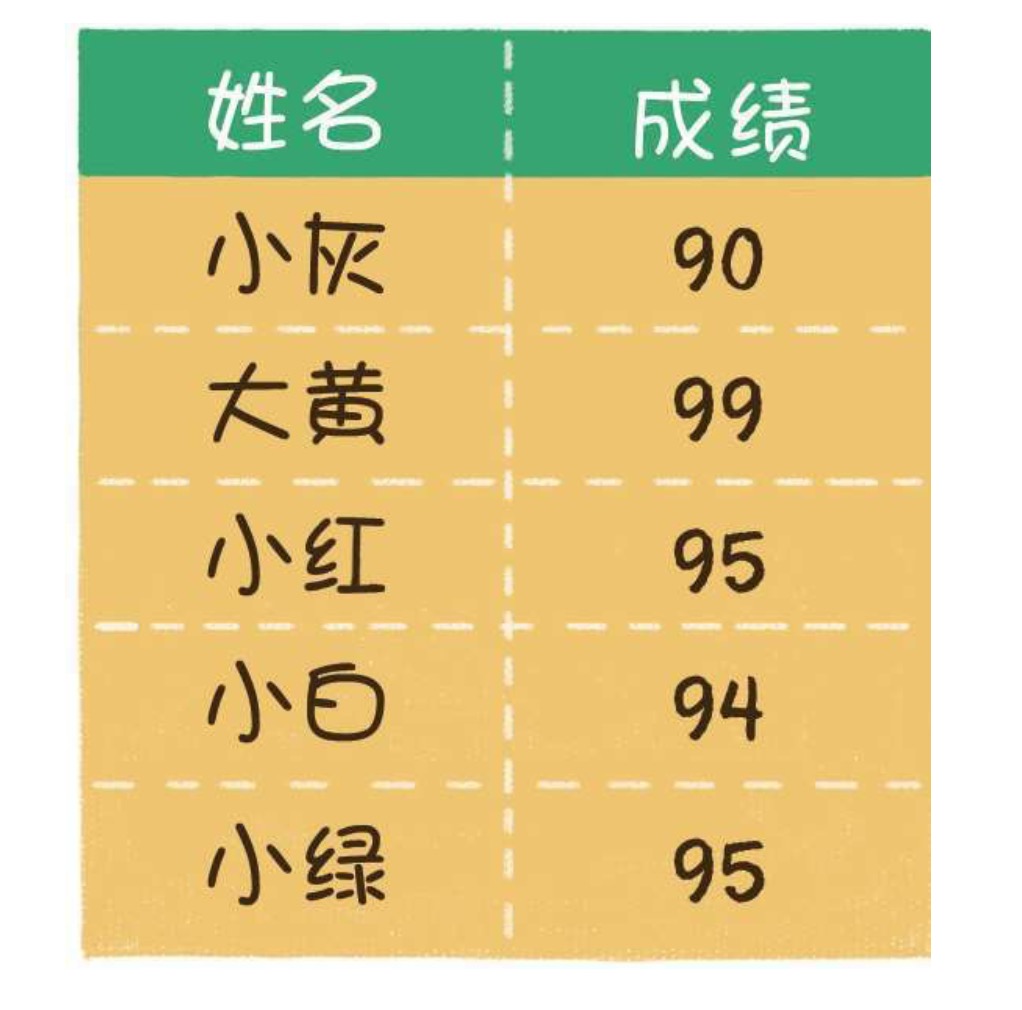
给出一个学生成绩表,要求按成绩从低到高进行排序,如果成绩相同,则遵循原表固有顺序。
那么,当我们填充统计数组以后,只知道有两个成绩并列为 95 分的同学,却不知道哪一个是小红,哪一个是小绿。
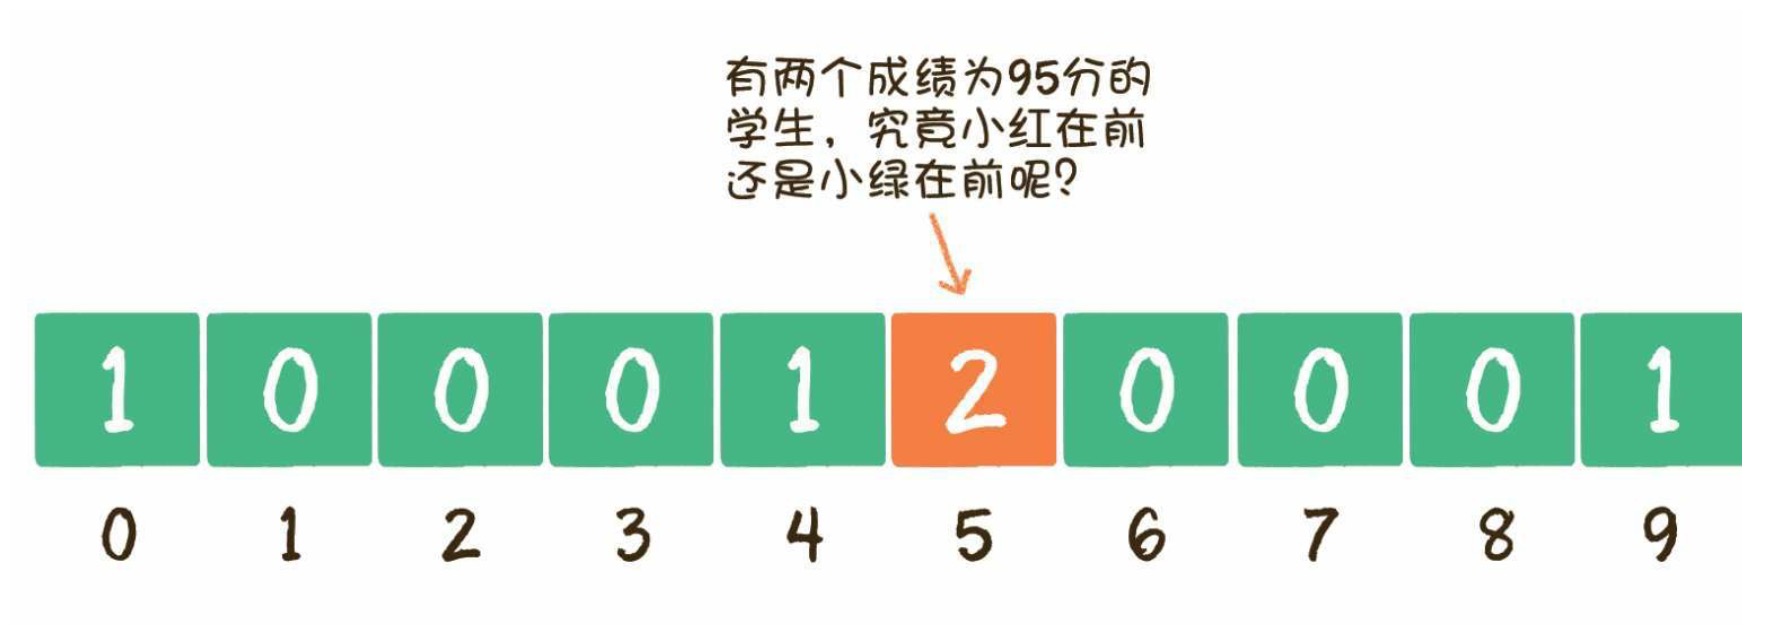
在这种情况下,需要稍微改变之前的逻辑,在填充完统计数组以后,对统计数组做一下变形。
仍然以刚才的学生成绩表为例,将之前的统计数组变形成下面的样子。
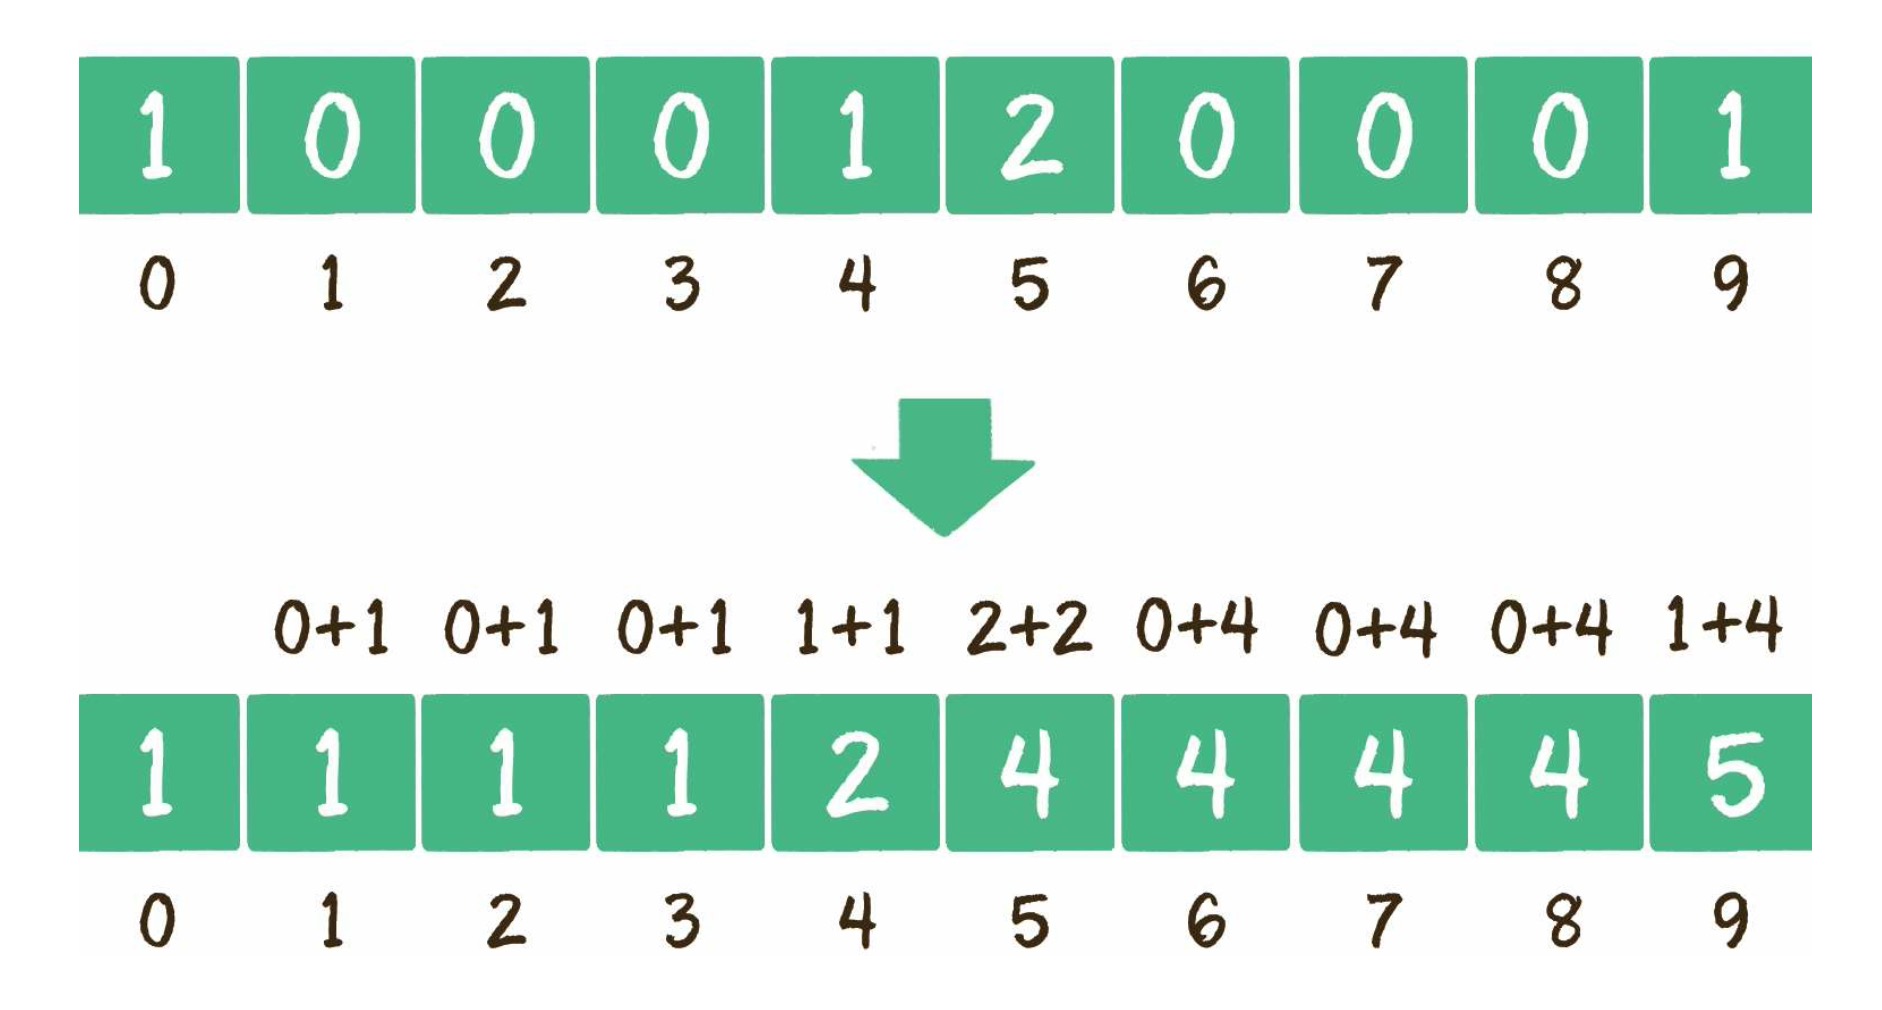
这是如何变形的呢?其实就是从统计数组的第 2 个元素开始,每一个元素都加上前面所有元素之和。
为什么要相加呢?
样相加的目的,是让统计数组存储的元素值,等于相应整数的最终排序位置的序号。例如下标是 9 的元素值为 5,代表原始数列的整数 9,最终的排序在第 5 位。
接下来,创建输出数组 sortedArray,长度和输入数列一致。然后从后向前遍历输入数列。
第 1 步,遍历成绩表最后一行的小绿同学的成绩。
小绿的成绩是 95 分,找到 countArray 下标是 5 的元素,值是 4,代表小绿的成绩排名位置在第 4 位。
同时,给 countArray 下标是 5 的元素值减 1,从 4 变成 3,代表下次再遇到 95 分的成绩时,最终排名是第 3。
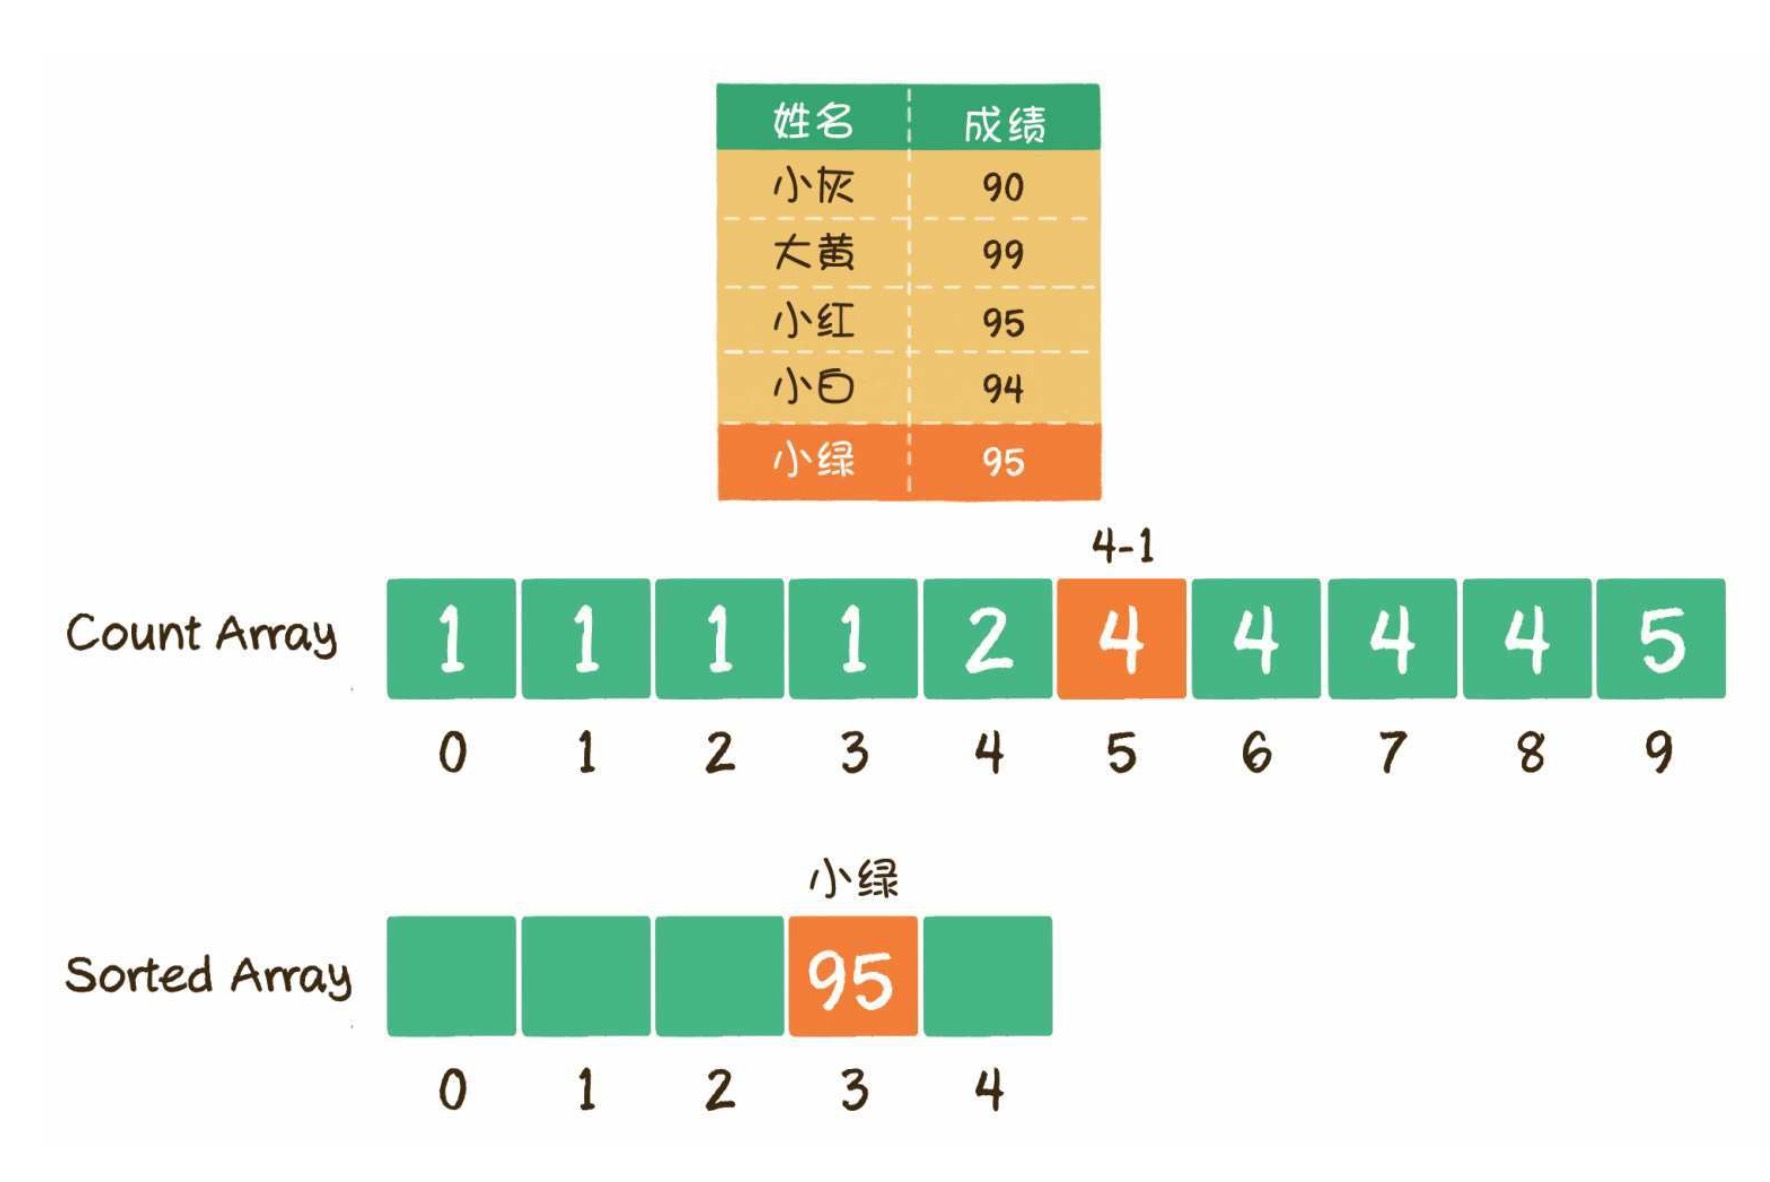
第 2 步,遍历成绩表倒数第 2 行的小白同学的成绩。
小白的成绩是 94 分,找到 countArray 下标是 4 的元素,值是 2,代表小白的成绩排名位置在第 2 位。
同时,给 countArray 下标是 4 的元素值减 1,从 2 变成 1,代表下次再遇到 94 分的 成绩时(实际上已经遇不到了),最终排名是第 1。
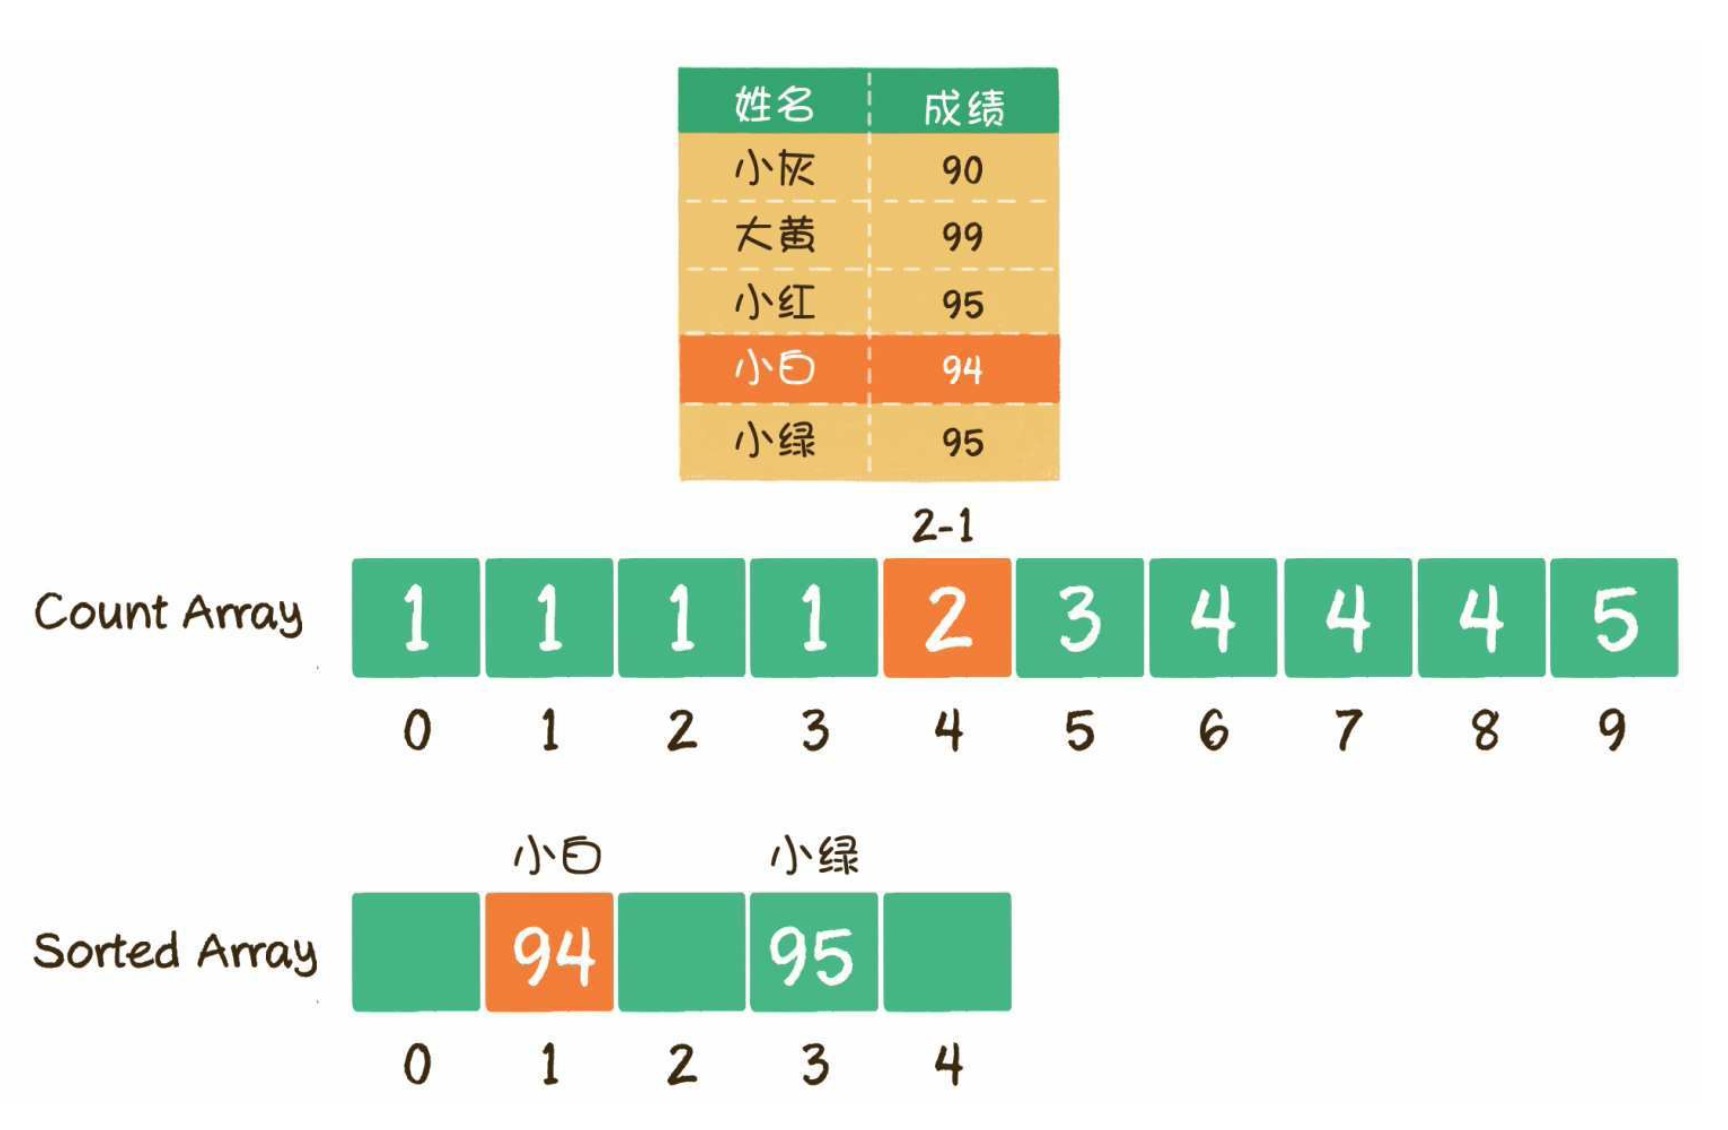
第 3 步,遍历成绩表倒数第 3 行的小红同学的成绩。
小红的成绩是 95 分,找到 countArray 下标是 5 的元素,值是 3(最初是 4,减 1 变 成了 3),代表小红的成绩排名位置在第 3 位。
同时,给 countArray 下标是 5 的元素值减 1,从 3 变成 2,代表下次再遇到 95 分的成绩时(实际上已经遇不到了),最终排名是第 2。
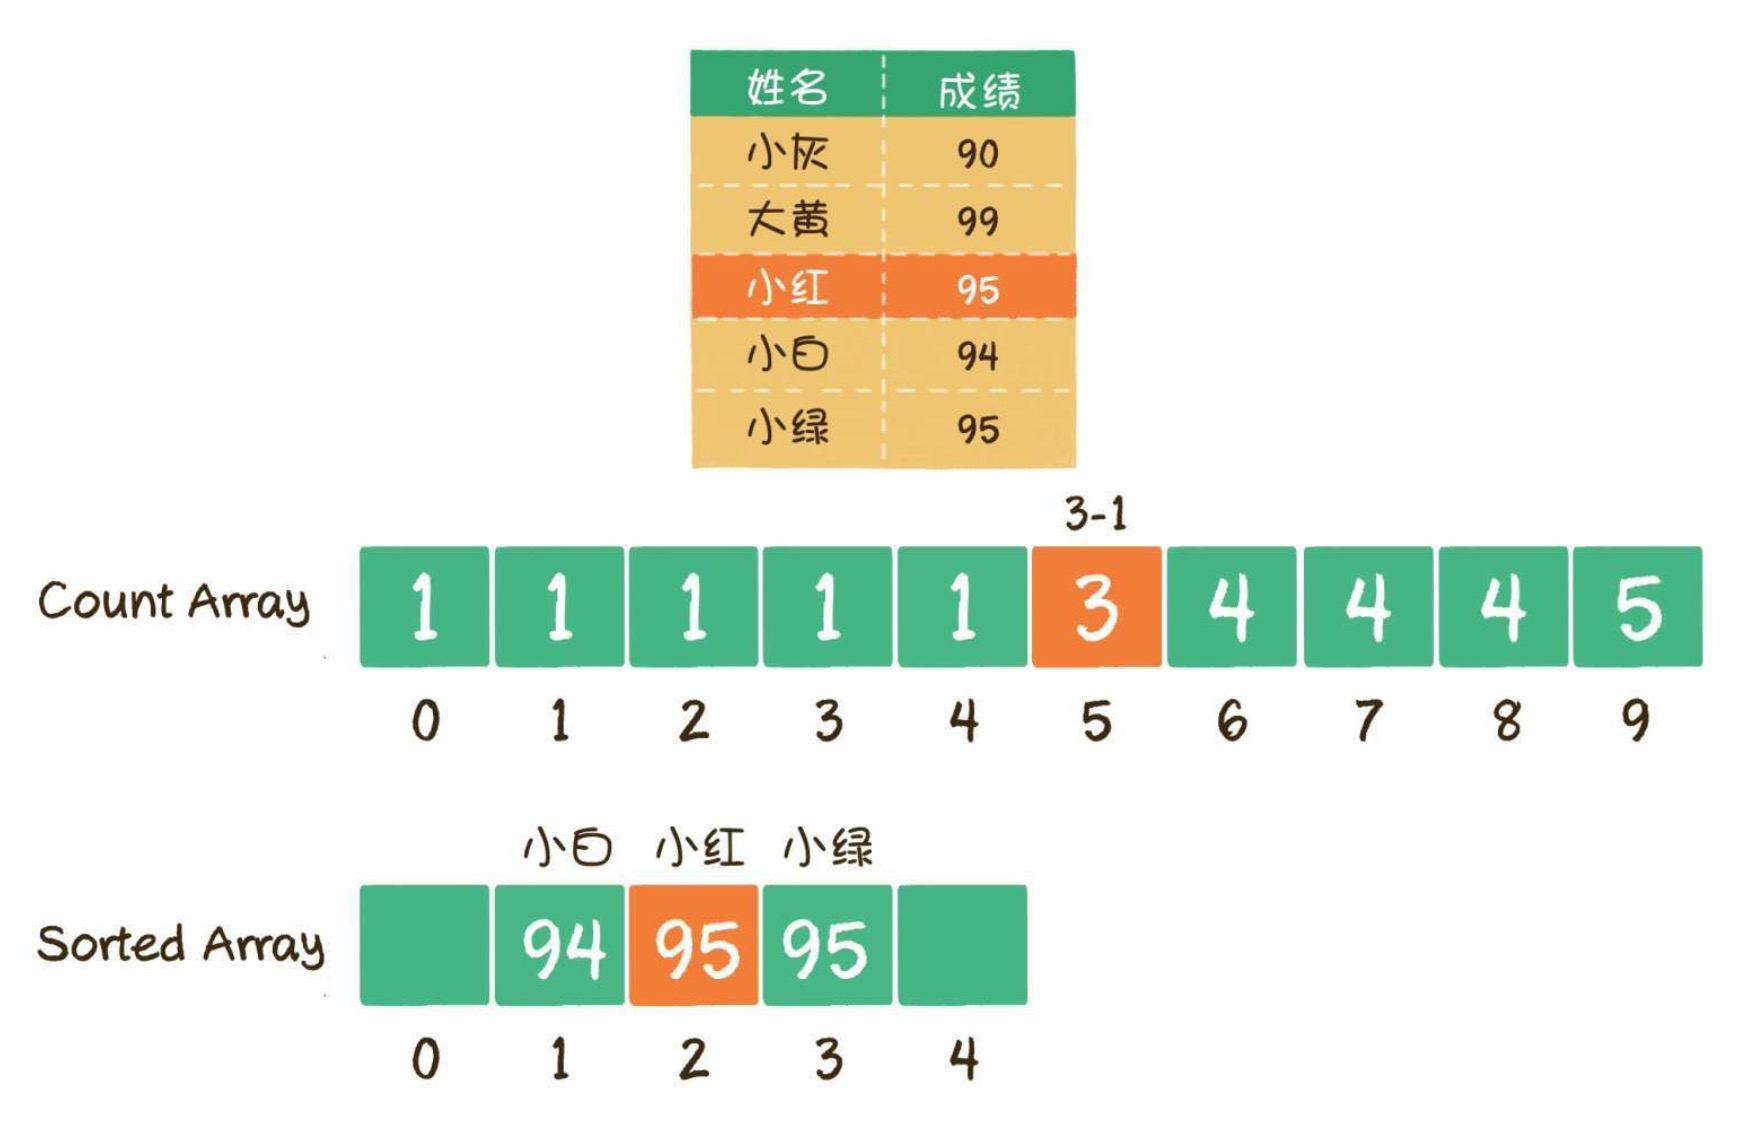
这样一来,同样是 95 分的小红和小绿就能够清楚地排出顺序了,也正因为此,优化版本的计数排序属于稳定排序。
后面的遍历过程以此类推。
function countSort(array) {
  // 1.得到数列的最大值和最小值,并算出差值d
  let min = array[0];
  let max = array[0];
  for (let i = 1; i < array.length; i++) {
    if (array[i] > max) {
      max = array[i];
    }
    if (array[i] < min) {
      min = array[i];
    }
  }
  const d = max - min;
  // 2.创建统计数组并统计对应元素的个数
  const countArray = new Array(d + 1).fill(0);
  for (let i = 0; i < array.length; i++) {
    // 数列的最小值作为一个偏移量,用于计算整数在统计数组中的下标
    countArray[array[i] - min]++;
  }
  // 3.统计数组做变形,后面的元素等于前面的元素之和
  for (let i = 1; i < countArray.length; i++) {
    countArray[i] += countArray[i - 1];
  }
  // 4.倒序遍历原始数列,从统计数组找到正确位置,输出到结果数组
  const sortedArray = new Array(array.length).fill(0);
  for (let i = array.length - 1; i >= 0; i--) {
    const offset = array[i] - min;
    sortedArray[countArray[offset] - 1] = array[i];
    countArray[offset]--;
  }
  return sortedArray;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
# 计数排序的局限性
1. 当数列最大和最小值差距过大时,并不适合用计数排序。
例如给出 20 个随机整数,范围在 0 到 1 亿之间,这时如果使用计数排序,需要创建长度为 1 亿的数组。不但严重浪费空间,而且时间复杂度也会随之升高。
2. 当数列元素不是整数时,也不适合用计数排序。
如果数列中的元素都是小数,如 25.213,或 0.00 000 001 这样的数字,则无法创建对应的统计数组。这样显然无法进行计数排序。
因此,计数排序只适用于正整数并且取值范围相差不大的数组排序使用,它的排序的速度是非常可观的。
# 桶排序
# 桶排序的思路
桶排序同样是一种线性时间的排序算法。类似于计数排序所创建的统计数组,桶排序需要创建若干个桶来协助排序。
每一个桶(bucket)代表一个区间范围,里面可以承载一个或多个元素。
桶排序的原理如下。
假设有一个非整数数列如下:
4.5,0.84,3.25,2.18,0.5
桶排序的第 1 步,就是创建这些桶,并确定每一个桶的区间范围。
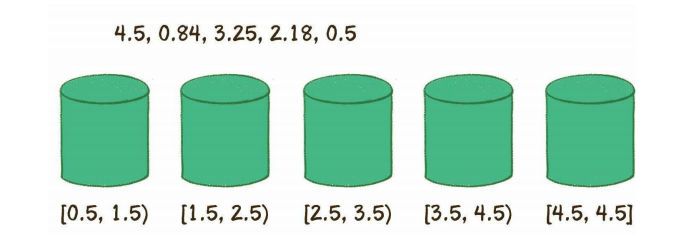
具体需要建立多少个桶,如何确定桶的区间范围,有很多种不同的方式。我们这里创建的桶数量等于原始数列的元素数量,除最后一个桶只包含数列最大值外,前面各个桶的区间按照比例来确定。
区间跨度 = (最大值-最小值)/ (桶的数量 - 1)
第 2 步,遍历原始数列,把元素对号入座放入各个桶中。
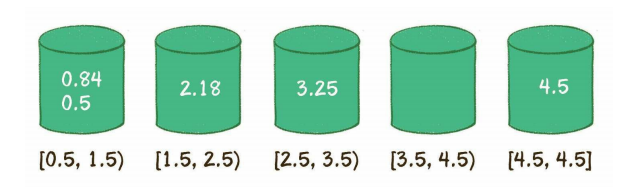
第 3 步,对每个桶内部的元素分别进行排序(显然,只有第 1 个桶需要排序)。
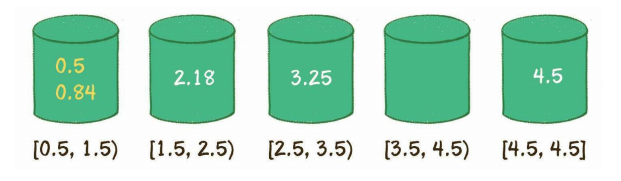
第 4 步,遍历所有的桶,输出所有元素。
0.5,0.84,2.18,3.25,4.5
到此为止,排序结束。
# 桶排序的实现
// 默认情况下,我们会使用 5 个桶。桶排序在所有元素平分到各个桶中时的表现最好。
// 如果元素非常稀疏,则使用更多的桶会更好。如果元素非常密集,则使用较少的桶会更好。
function bucketSort(array, bucketSize = 5) {
  if (array.length < 2) {
    return array;
  }
  // 创建桶并将元素分布到不同的桶中
  const buckets = createBuckets(array, bucketSize);
  // 对每个桶执行插入排序算法和将所有桶合并为排序后的结果数组
  return sortBuckets(buckets);
}

// 创建桶
function createBuckets(array, bucketSize) {
  let minValue = array[0];
  let maxValue = array[0];
  for (let i = 1; i < array.length; i++) {
    if (array[i] < minValue) {
      minValue = array[i];
    } else if (array[i] > maxValue) {
      maxValue = array[i];
    }
  }
  // 计算每个桶中需要分布的元素个数
  // 计算方法是:计算数组最大值和最小值的差值并与桶的大小进行除法计算
  const bucketCount = Math.floor((maxValue - minValue) / bucketSize) + 1;
  const buckets = [];
  for (let i = 0; i < bucketCount; i++) {
    buckets[i] = [];
  }
  // 遍历数组中的每个元素,计算要将元素放到哪个桶中,并将元素插入正确的桶中
  for (let i = 0; i < array.length; i++) {
    const bucketIndex = Math.floor((array[i] - minValue) / bucketSize);
    buckets[bucketIndex].push(array[i]);
  }
  return buckets;
}

// 将每个桶进行排序
function sortBuckets(buckets) {
  const sortedArray = [];
  for (let i = 0; i < buckets.length; i++) {
    if (buckets[i] != null) {
      // 遍历每个可迭代的桶并应用插入排序,根据场景,我们还可以应用其他的排序算法,例如快速排序
      insertSort(buckets[i]);
      sortedArray.push(...buckets[i]);
    }
  }
  return sortedArray;
}

// 插入排序
function insertSort(arr) {
  for (let i = 1; i < arr.length; i++) {
    const value = arr[i];
    let j = 0; // 插入的位置
    for (j = i - 1; j >= 0 && arr[j] > value; j--) {
      arr[j + 1] = arr[j]; // 移动数据
    }
    arr[j + 1] = value; // 插入数据
  }
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
# 基数排序
# 基数排序的思路
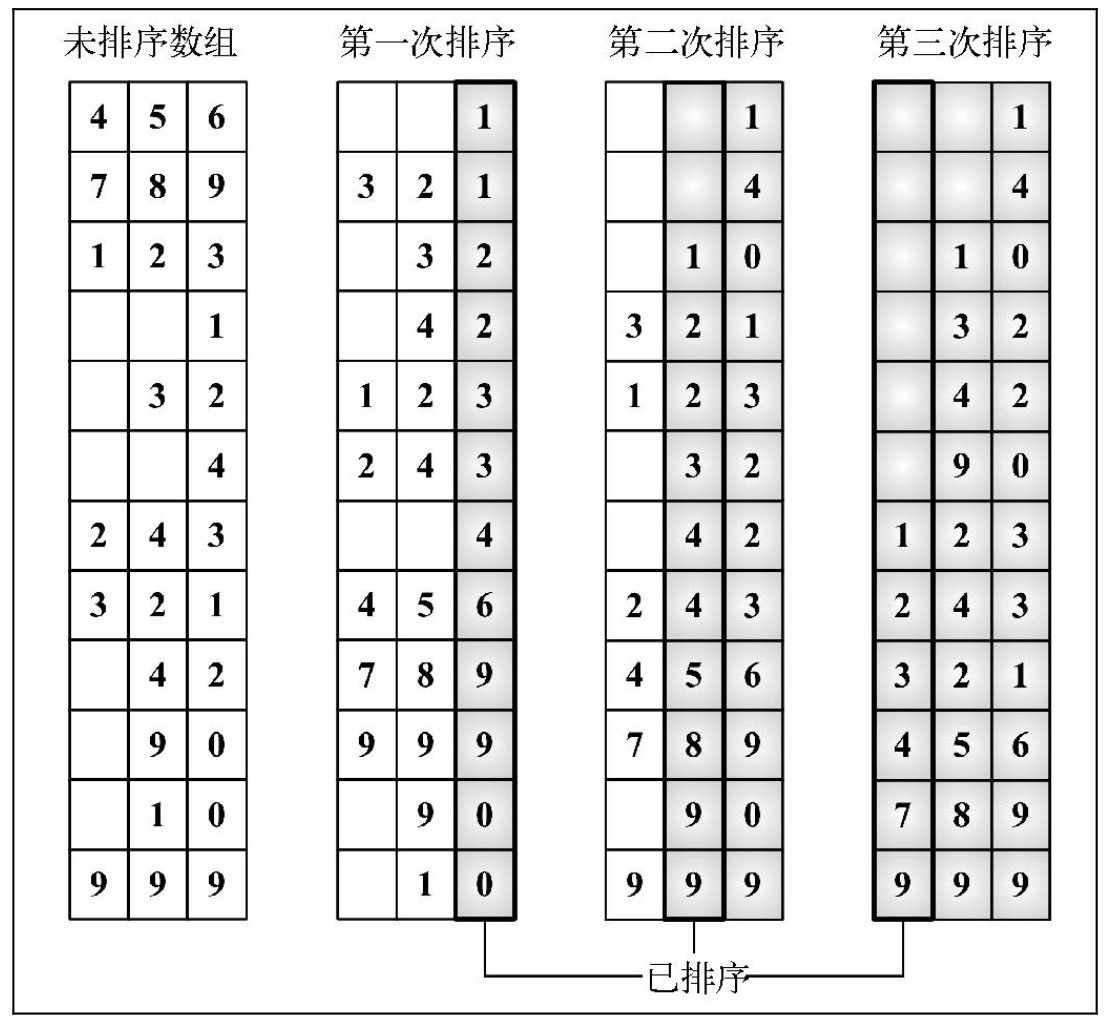
基数排序也是一个分布式排序算法,它根据数字的有效位或基数(这也是它为什么叫基数排序)将整数分布到桶中。基数是基于数组中值的记数制的。
比如,对于十进制数,使用的基数是 10。因此,算法将会使用 10 个桶用来分布元素并且首先基于个位数字进行排序,然后基于十位数字,然后基于百位数字,以此类推。
# 基数排序的实现
function radixSort(array, radixBase = 10) {
  if (array.length < 2) {
    return array;
  }
  const minValue = Math.min(...array);
  const maxValue = Math.max(...array);
  // 基数排序也用来排序整数,我们就从最后一位开始排序所有的数,这个算法也可以被修改成支持排序字母字符。
  let significantDigit = 1;
  // 首先只会基于最后一位有效位对数字进行排序,在下次迭代时,我们会基于第二个有效位进行排序(十位数字),
  // 然后是第三个有效位(百位数字),以此类推。我们继续这个过程直到没有待排序的有效位
  // 这也是为什么我们需要知道数组中的最小值和最大值。
  // 如果数组中包含的值都在 1~9,以下循环只会执行一次。如果值都小于 99,则循环会执行第二次,以此类推。
  while ((maxValue - minValue) / significantDigit >= 1) {
    array = countingSortForRadix(array, radixBase, significantDigit, minValue);
    significantDigit *= radixBase;
  }
  return array;
}

function countingSortForRadix(array, radixBase, significantDigit, minValue) {
  let bucketsIndex;
  const buckets = [];
  const res = [];
  // 基于基数初始化桶,由于我们排序的是十进制数,那么需要 10 个桶。
  for (let i = 0; i < radixBase; i++) {
    buckets[i] = 0;
  }
  // 基于数组中数的有效位进行计数排序
  for (let i = 0; i < array.length; i++) {
    bucketsIndex = Math.floor(
      ((array[i] - minValue) / significantDigit) % radixBase
    ); // 有效位
    buckets[bucketsIndex]++; // 计数排序
  }
  // 由于我们进行的是计数排序,我们还需要计算累积结果来得到正确的计数值
  for (let i = 1; i < radixBase; i++) {
    buckets[i] += buckets[i - 1];
  }
  // 对原始数组中的每个值,我们会再次获取它的有效位并将它的值移动到 res 数组中(从 buckets 数组中减去它的计数值)
  for (let i = array.length - 1; i >= 0; i--) {
    bucketsIndex = Math.floor(
      ((array[i] - minValue) / significantDigit) % radixBase
    );
    res[--buckets[bucketsIndex]] = array[i];
  }
  return res;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47